
D2L-38 全连接神经网络FCN
Published:
本文围绕用于语义分割的 FCN 展开,介绍将分类网络转为像素预测网络的思路,说明双线性插值与上采样的作用,并展示模型构建和训练代码。
🎦 本节课程视频地址 👇
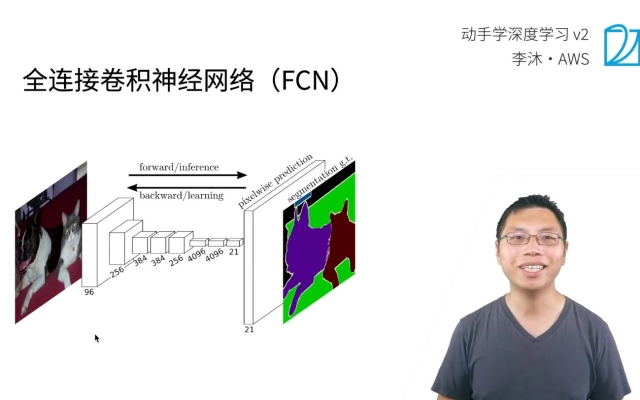
全连接神经网络(FCN, Fully Connected Network)
- FCN是用深度神经网络来做语义分割的奠基性工作
- 它用转置卷积层来替换CNN最后的全局平均池化层+全连接层,从而可以实现每个像素的预测
- 输出通道数为类别数,高宽与原图一致
双线性插值
Interpolation is a method of constructing new data points within the range of a discrete set of known data points. Image interpolation refers to the“guess”of intensity values at missing locations.
单线性插值
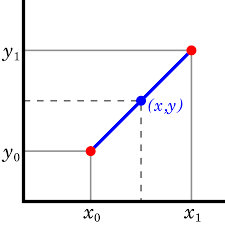
分子可以看作 \(x\) 与 \(x_1\), \(x_2\) 距离的权重,\(y_1\), \(y_2\) 是加权系数。
\[f(P)={x_2-x\over x_2-x_1}f(P_1)+{x-x_1\over x_2-x_1}f(P_2)\]双线性插值
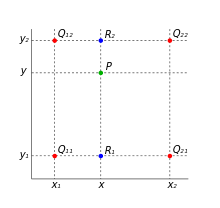
借助四个点,每两个像素之间的距离是1,即\((x_2-x_1)=(y_2-y_1)=1\)
\[\begin{split}f(x,y)=&f(Q_{11})(x_2-x)(y_2-y)\\&+f(Q_{21})(x_1-x)(y_2-y)\\&+f(Q_{12})(x_2-x)(y_1-y)\\&+f(Q_{22})(x_1-x)(y_2-y)\end{split}\] \[\begin{split}f(x,y)=&f(Q_{11})w_{11}+f(Q_{21})w_{21}+f(Q_{12})w_{12}+f(Q_{22})w_{22}\end{split}\]可以理解为每个像素的权重是所求点与其对角线像素坐标的距离之积
意义
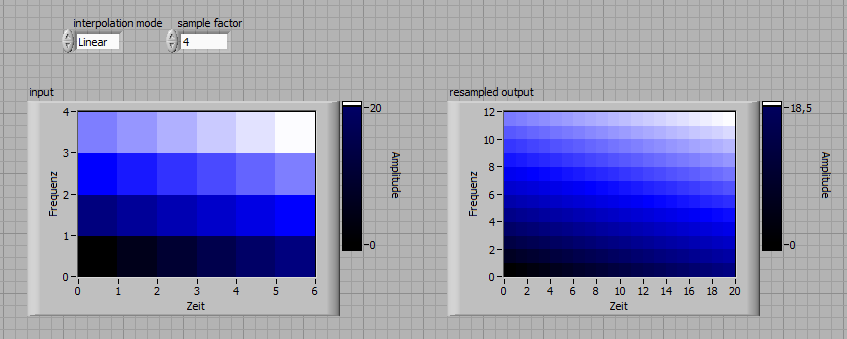
通过双线性插值,就可以放大图片,或者说在像素之间插值,找到颜色的过渡
代码实现
定义网络
%matplotlib inline
import torch
import torchvision
from torch import nn
from torch.nn import functional as F
from d2l import torch as d2l

pretrained_net = torchvision.models.resnet18(pretrained=True)
list(pretrained_net.children())[-3:]
##Returns an iterator over immediate children modules

net = nn.Sequential(*list(pretrained_net.children())[:-2])
#pretrained_net.children()是一个生成器
#刨去最后的全局平均池化层和全连接
X = torch.rand(size=(1, 3, 320, 480))
net(X).shape

num_classes = 21
net.add_module('final_conv', nn.Conv2d(512, num_classes, kernel_size=1))
#用1x1把通道数改变到类别数,减小了后续的计算量,会有精度损失
net.add_module('transpose_conv', nn.ConvTranspose2d(num_classes, num_classes,
                                    kernel_size=64, padding=16, stride=32))
#padding=16使卷积核可以在原本高宽上完全移动,不会存在不足额
双线性插值初始化卷积核
def bilinear_kernel(in_channels, out_channels, kernel_size):
    #利用双线性插值初始化转置卷积核
    factor = (kernel_size + 1) // 2
    if kernel_size % 2 == 1:
        center = factor - 1
    else:
        center = factor - 0.5
    og = (torch.arange(kernel_size).reshape(-1, 1),
          torch.arange(kernel_size).reshape(1, -1))
    filt = (1 - torch.abs(og[0] - center) / factor) * \
           (1 - torch.abs(og[1] - center) / factor)
    #可以简单理解为og[0]/[1] - center是插值出的点与中心的距离
    #/ factor是散点距离之于总距离的比例
    #1 - 是把比例倒置,使中心权重高,两边权重低
    #也就是说插值越靠中心的点越接近被卷积之前像素的值
    weight = torch.zeros((in_channels, out_channels,
                          kernel_size, kernel_size))
    weight[range(in_channels), range(out_channels), :, :] = filt
    return weight

    conv_trans = nn.ConvTranspose2d(3, 3, kernel_size=4, padding=1, stride=2,
                                bias=False)
#高宽乘2
conv_trans.weight.data.copy_(bilinear_kernel(3, 3, 4));
#复制目标张量的元素
作用于图片
img = torchvision.transforms.ToTensor()(d2l.Image.open('../data/test_img.jpg'))
# 把HWC的图片转换成CHW的张量
# torchvision.transforms.ToTensor()是模块本身,()应该传入定义模块的参数
#亦如net=nn.Conv2d(), net(X)
#(Image.open())最外层括号是调用模块
#相当于实现了nn.Module.__call__()
X = img.unsqueeze(0)
#batch_size维
Y = conv_trans(X)
out_img = Y[0].permute(1, 2, 0).detach()
#permute()把图片拉伸以后再转换成HWC顺序
#detach()Returns a new Tensor, detached from the current graph.
#The result will never require gradient.
#可以理解为如果存在求导环节,被detach()出的变量不受影响

d2l.set_figsize()
print('input image shape:', img.permute(1, 2, 0).shape)
d2l.plt.imshow(img.permute(1, 2, 0));
print('output image shape:', out_img.shape)
d2l.plt.imshow(out_img);
训练与预测
W = bilinear_kernel(num_classes, num_classes, 64)
net.transpose_conv.weight.data.copy_(W);

batch_size, crop_size = 32, (320, 480)
train_iter, test_iter = d2l.load_data_voc(batch_size, crop_size)

def loss(inputs, targets):
    return F.cross_entropy(inputs, targets, reduction='none').mean(1).mean(1)
    #对高宽loss做平均,拿到一个值
    #因为没有保留维度,所以可以两次对第一维求平均

num_epochs, lr, wd, devices = 5, 0.001, 1e-3, d2l.try_all_gpus()
trainer = torch.optim.SGD(net.parameters(), lr=lr, weight_decay=wd)
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs, devices)

def predict(img):
    X = test_iter.dataset.normalize_image(img).unsqueeze(0)
    pred = net(X.to(devices[0])).argmax(dim=1)
    #在通道维上做预测,相当于把预测最大的类别的标号拿出来
    return pred.reshape(pred.shape[1], pred.shape[2])
    #把预测结果转变成高宽模式,也就是每个像素的位置对应预测的类别

def label2image(pred):
    colormap = torch.tensor(d2l.VOC_COLORMAP, device=devices[0])
    X = pred.long()
    return colormap[X, :]
    #像素类别与颜色的映射
    #我猜测colormap只有一列
    #切片相当于保留了X的形状,把colormap的对应行放入,因为一列只有一个元素,所以可以不保留维度

voc_dir = d2l.download_extract('voc2012', 'VOCdevkit/VOC2012')
test_images, test_labels = d2l.read_voc_images(voc_dir, False)
n, imgs = 4, []
for i in range(n):
    crop_rect = (0, 0, 320, 480)
    X = torchvision.transforms.functional.crop(test_images[i], *crop_rect)
    pred = label2image(predict(X))
    imgs += [X.permute(1,2,0), pred.cpu(),
             torchvision.transforms.functional.crop(
                 test_labels[i], *crop_rect).permute(1,2,0)]
d2l.show_images(imgs[::3] + imgs[1::3] + imgs[2::3], 3, n, scale=2);
#切片::3,是步长,没有逗号就只是在一个维度上操作。