D2L-43 循环神经网络RNN
Published:
本文介绍循环神经网络如何借助隐状态处理序列,说明语言模型的训练与预测过程,并给出 RNN 的从零实现与 PyTorch 简洁实现。
🎦 本节课程视频地址 👇
循环神经网络(RNN, Recurrent Neural Network)
循环神经网络
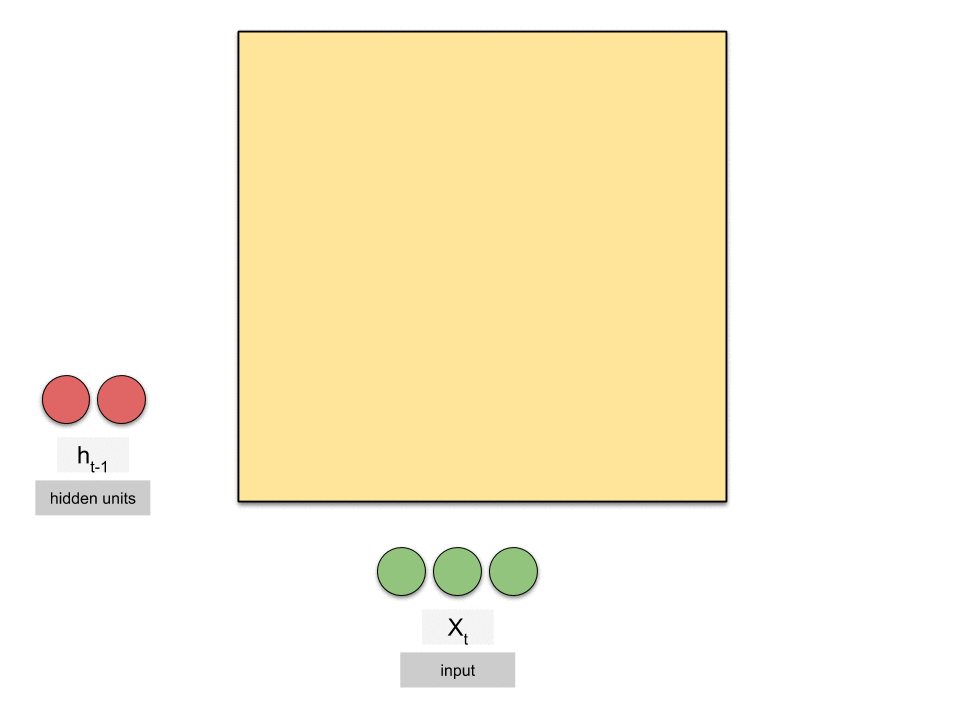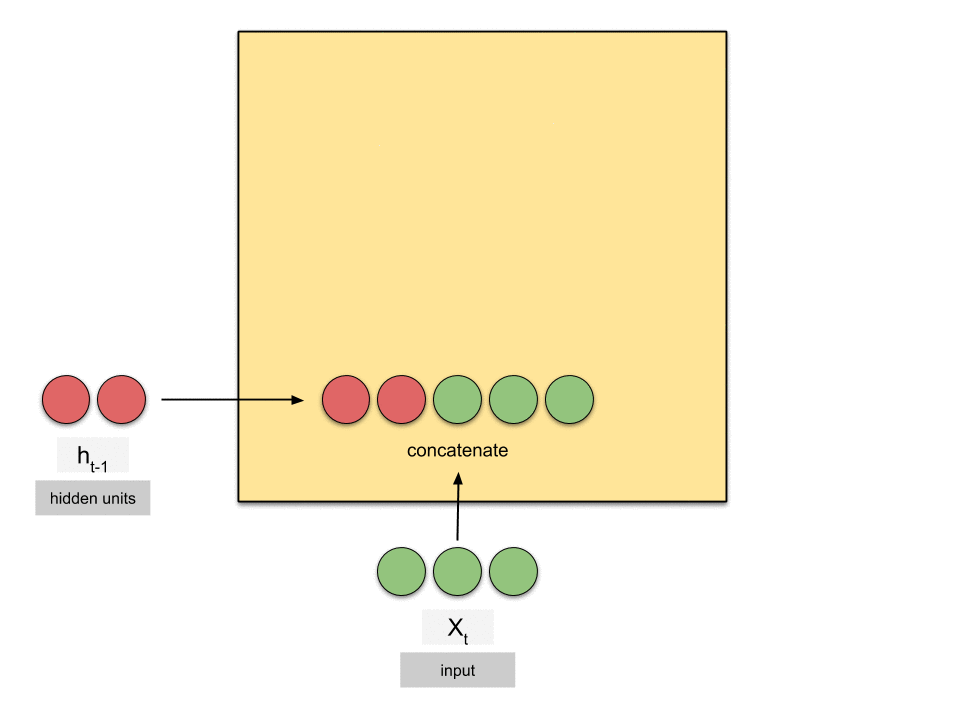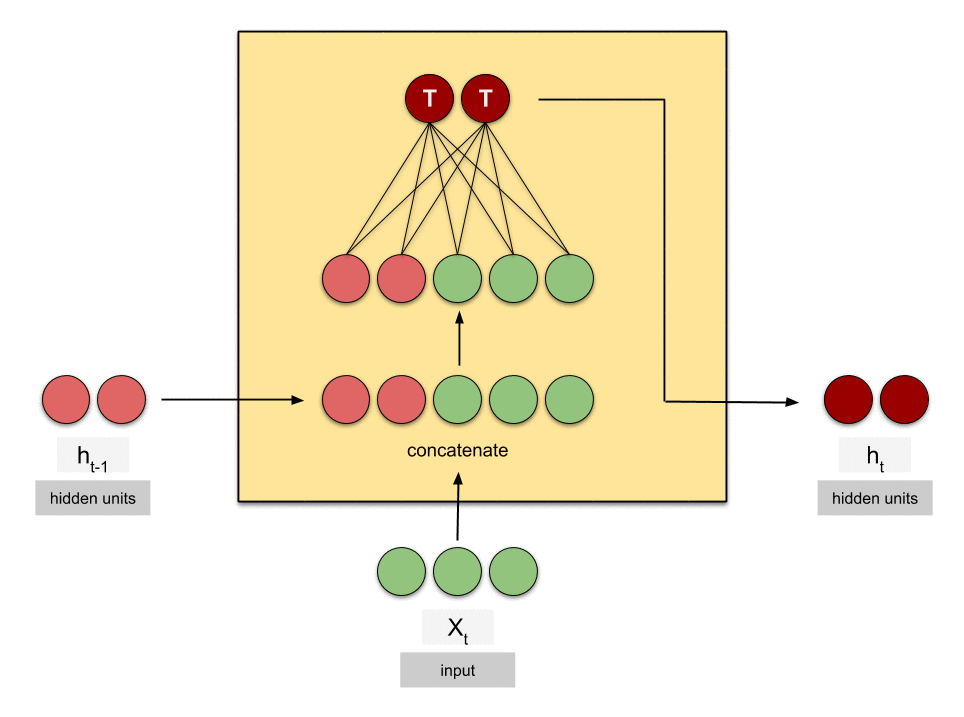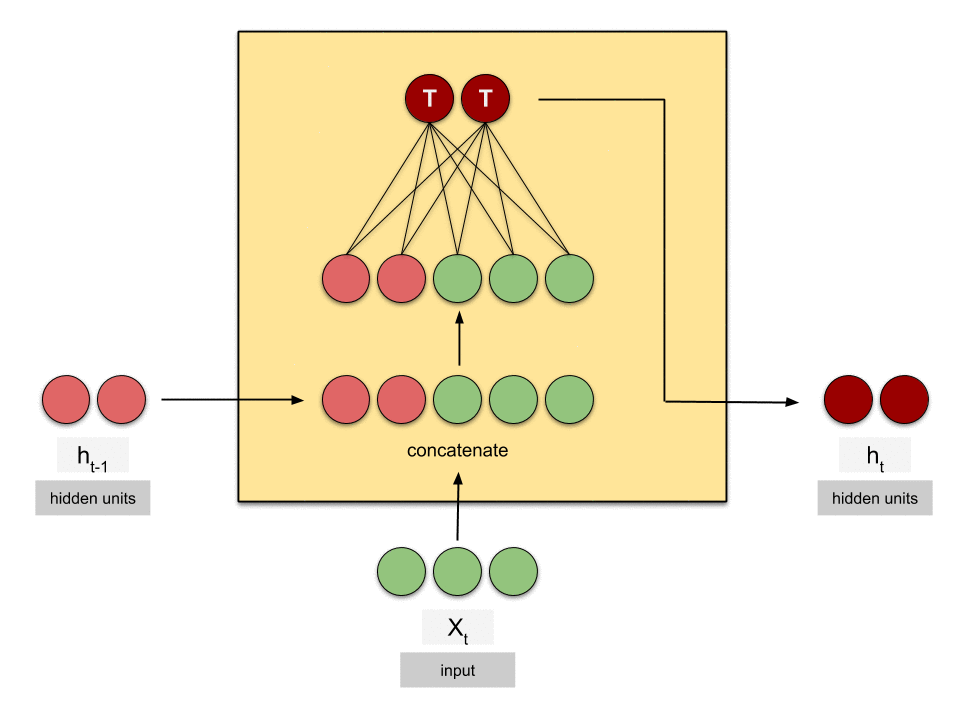
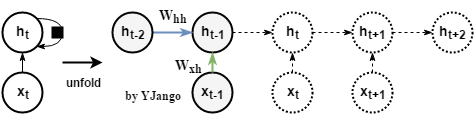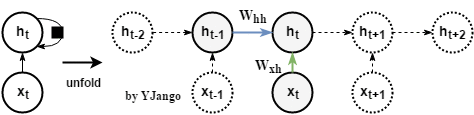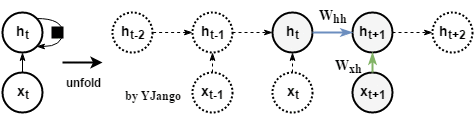
- 更新隐藏状态:\(\bf h_t=\phi(W_{hh}h_{t-1}+W_{hx}x_{t-1}+b_h)\)
- 去掉了 \(\bf W_{hh}h_{t-1}\) 就是MLP
- \(\bf W_{hh}\) 就用来存储时序信息
- 输出:\(\bf o_t=\phi(W_{ho}h_t+b_o)\)
- 激活函数为 \(\phi\)
困惑度(Perplexity)
- 衡量一个语言模型的好坏可以用平均交叉熵 \(\pi = {1\over n}\sum_{i=1}^n-\log p(x_t\vert x_{t-1},...)\)
- \(-\log p(x_t\vert x_{t-1},...)\) 是真实值预测概率的softmax输出。 \(p\) 是语言模型的预测概率, \(x_t\) 是真实词
- 一个长度为 \(n\) 的序列,做分类,平均的交叉熵
- 历史原因NLP使用困惑度 \(exp(\pi)\) 来衡量,是平均每次可能选项
- 1表示完美,无穷大师最差情况
- 做指数使数值变大(分散)
梯度剪裁
- 迭代中计算这 \(T\) 个时间步上的梯度,在反向传播过程中产生长度为 \(O(T)\) 的矩阵乘法链,导致数值不稳定。
- 梯度剪裁能有效预防梯度爆炸
- 如果梯度长度超过 \(\theta\),那么拖移回长度 \(\theta\)。 \({\bf g} \leftarrow \min\left(1, {\theta\over\vert \vert \bf g\vert \vert }\right)\bf g\) \(\vert \vert {\bf g}\vert \vert =len(\bf g)\)
更多的应用RNNs
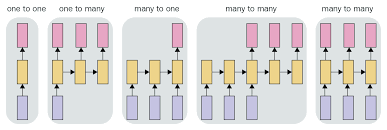
- one to many 文本生成
- MLP,无时序信息
- many to one 文本分类
- many to many1 问答、机器翻译
- many to many2 Tag 生成
- 对每一个词进行分类
总结
- 循环神经网络的输出取决于当下的输入和前一时间的隐变量
- 应用到语言模型中时,循环神经网络根据当前词预测下一次时刻词
- 通常使用困惑度来衡量语言模型的好坏
从零开始实现
导入包和预处理
%matplotlib inline
import math
import torch
from torch import nn
from torch.nn import functional as F
from d2l import torch as d2l

batch_size, num_steps = 32, 35
train_iter, vocab = d2l.load_data_time_machine(batch_size, num_steps)

#独热编码
F.one_hot(torch.tensor([0, 2]), len(vocab))
#两个1的索引([0, 2]),向量长度len(vocab)

X = torch.arange(10).reshape((2, 5))
# 批量大小为2,时间步数是5
F.one_hot(X.T, 28).shape
# 转置,时序上连续
初始化参数
def get_params(vocab_size, num_hiddens, device):
    num_inputs = num_outputs = vocab_size
    # 输入是一连串词汇,通过one-hot变成一个长为vobab_size的向量
    # 输出是多类分类,预测的可能结果都来源于vocab_size

    def normal(shape):
        return torch.randn(size=shape, device=device) * 0.01
        # 返回服从正态分布的随机变量 N~(0,1)
        # 再放缩到0.01

    # 隐藏层参数
    W_xh = normal((num_inputs, num_hiddens))
    #x(t)预测h(t)
    W_hh = normal((num_hiddens, num_hiddens))
    #h(t-1)预测h(t)
    b_h = torch.zeros(num_hiddens, device=device)
    # 偏移为0
    W_hq = normal((num_hiddens, num_outputs))
    #h(t)预测o(t)
    b_q = torch.zeros(num_outputs, device=device)
    # 偏移为0
    params = [W_xh, W_hh, b_h, W_hq, b_q]
    for param in params:
        param.requires_grad_(True)
        #Change if autograd should record operations on parameters
        #This method sets the parameters' requires_grad attributes in-place.
    return params

def init_rnn_state(batch_size, num_hiddens, device):
    #初始化隐藏状态h(0)
    return (torch.zeros((batch_size, num_hiddens), device=device), )
    #放在一个元组里,为以后的LST做准备
定义网络
def rnn(inputs, state, params):
    #state初始化的隐藏状态
    W_xh, W_hh, b_h, W_hq, b_q = params
    H, = state
    #表示接受赋值的是state里的元素
    outputs = []
    # X的形状:(批量大小,词表大小)
    for X in inputs:
        #三D张量,时序-批量大小-时间步数
        #循环于每个时间维度
        H = torch.tanh(torch.mm(X, W_xh) + torch.mm(H, W_hh) + b_h)
        #H(t)=X(t)W_xh+H(t-1)W_hh
        #(batch_size, vocab_size)*(vacob_size,num_hiddens)
        #(batch_size, num_hiddens)*(num_hiddens,num_hiddens)
        Y = torch.mm(H, W_hq) + b_q
        # (batch_size,num_hiddens)*(num_hiddens, vocab_size)
        outputs.append(Y)
        #(num_steps, batch_size,vocab_size)
    return torch.cat(outputs, dim=0), (H,)
    #把输出的Y按照第零维度连接
    #cat接收一个tuple,拆开第一个维度(num_steps)
    #把元素按行连接
    #(num_steps*batch_size,vocab_size)
# 定义类封装前方功能
class RNNModelScratch:
    """从零开始实现的循环神经网络模型"""
    def __init__(self, vocab_size, num_hiddens, device,
                 get_params, init_state, forward_fn):
        self.vocab_size, self.num_hiddens = vocab_size, num_hiddens
        self.params = get_params(vocab_size, num_hiddens, device)
        # return params
        self.init_state, self.forward_fn = init_state, forward_fn
        # init_state初始化的H的函数
        # forward_fn是RNN网络本身

    def __call__(self, X, state):
        X = F.one_hot(X.T, self.vocab_size).type(torch.float32)
        #把整形变成浮点型,很重要
        return self.forward_fn(X, state, self.params)

    def begin_state(self, batch_size, device):
        return self.init_state(batch_size, self.num_hiddens, device)

num_hiddens = 512
net = RNNModelScratch(len(vocab), num_hiddens, d2l.try_gpu(), get_params,
                      init_rnn_state, rnn)
state = net.begin_state(X.shape[0], d2l.try_gpu())
#没转置的X[0]是batch_size
Y, new_state = net(X.to(d2l.try_gpu()), state)
# X(2,5,28)
# state 是元组(H,)
Y.shape, len(new_state), new_state[0].shape
定义预测批次
#训练和预测的都是文本里每一个char的独热
def predict_ch8(prefix, num_preds, net, vocab, device):
    #prefix 句子的开头
    #num_preds生成多少个词(这里是字符)
    state = net.begin_state(batch_size=1, device=device)
    outputs = [vocab[prefix[0]]]
    #第一个字符串在vocab里的下标
    get_input = lambda: torch.tensor([outputs[-1]], device=device).reshape((1, 1))
    #定义匿名函数可以直接赋值给变量
    #outputs最近预测的词变成tensor
    #时间步长1,批量大小1
    for y in prefix[1:]:
        _, state = net(get_input(), state)
        #返回的是state=(H,), h(t)
        #_是cat起来的预测结果, (num_steps,vocab_size)
        #Y(1-num_steps),Y[0]=X[0]不需要预测
        outputs.append(vocab[y])
        #添加真实的prefix[1]
        #output == prefix
    #非常巧妙,从prefix[1]开始传入,却把prefix[0]作为输入
    #所以把prefix[1:]全部放入后,只运行了len(prefix)-1次
    #最后预测未知字符的H和预测值并没有参与
    for _ in range(num_preds):
        #紧接着前面
        y, state = net(get_input(), state)
        #从_=0开始
        #这里的state就是倒数第二步的H
        #get_input()拿到了prefix里最后一个字符
        #预测的就是未知处的第一个字符
        outputs.append(int(y.argmax(dim=1).reshape(1)))
        #返回预测最大值处的下标
        #也就是其在独热中的索引
    return ''.join([vocab.idx_to_token[i] for i in outputs])
    #把index转成token,用''相连
    #char.join([])用char连接[]里的字符串

predict_ch8('time traveller ', 10, net, vocab, d2l.try_gpu())
梯度剪裁
#辅助函数-梯度剪裁
def grad_clipping(net, theta):
    """裁剪梯度"""
    if isinstance(net, nn.Module):
        params = [p for p in net.parameters() if p.requires_grad]
        #用nn.Module的方式
    else:
        params = net.params
    #拿出所有参数
    norm = torch.sqrt(sum(torch.sum((p.grad ** 2)) for p in params))
    #W_xh, W_hh, b_h, W_hq, b_q
    #所有梯度平方和开根号
    if norm > theta:
        for param in params:
            param.grad[:] *= theta / norm
            #[:]表示所有元素
定义批次训练
def train_epoch_ch8(net, train_iter, loss, updater, device, use_random_iter):

    state, timer = None, d2l.Timer()
    metric = d2l.Accumulator(2)
    for X, Y in train_iter:
        #X,Y(batch_size, num_stpes)
        if state is None or use_random_iter:
            # 随机批量
            state = net.begin_state(batch_size=X.shape[0], device=device)
            # 如果是随机批量,每一次循环都要初始化H全零
            # 因为上一刻的信息和这一刻的信息在时序上不是连续的
        else:
            if isinstance(net, nn.Module) and not isinstance(state, tuple):
                state.detach_()
                # detach_()表示在此处计算图停止传播
                # 也就是说反向梯度在state前面的参数接收不到
                # 因为backward()只能在同一个iteration里面进行
                # 所以前面时序算出来的H不需要在此被更新权重
            else:
                # state对于nn.LSTM或对于我们从零开始实现的模型是个张量
                for s in state:
                    s.detach_()
        y = Y.T.reshape(-1)
        #按时间序列拉成一行
        X, y = X.to(device), y.to(device)
        y_hat, state = net(X, state)
        l = loss(y_hat, y.long()).mean()
        if isinstance(updater, torch.optim.Optimizer):
            updater.zero_grad()
            l.backward()
            grad_clipping(net, 1)
            #梯度剪裁
            updater.step()
        else:
            l.backward()
            grad_clipping(net, 1)
            # 因为已经调用了mean函数
            updater(batch_size=1)
        metric.add(l * y.numel(), y.numel())
    return math.exp(metric[0] / metric[1]), metric[1] / timer.stop()
    #计算困惑度
定义epoch训练
def train_ch8(net, train_iter, vocab, lr, num_epochs, device,
              use_random_iter=False):
    loss = nn.CrossEntropyLoss()
    animator = d2l.Animator(xlabel='epoch', ylabel='perplexity',
                            legend=['train'], xlim=[10, num_epochs])
    if isinstance(net, nn.Module):
        updater = torch.optim.SGD(net.parameters(), lr)
    else:
        updater = lambda batch_size: d2l.sgd(net.params, lr, batch_size)
    predict = lambda prefix: predict_ch8(prefix, 50, net, vocab, device)
    for epoch in range(num_epochs):
        ppl, speed = train_epoch_ch8(
            net, train_iter, loss, updater, device, use_random_iter)
        if (epoch + 1) % 10 == 0:
            print(predict('time traveller'))
            animator.add(epoch + 1, [ppl])
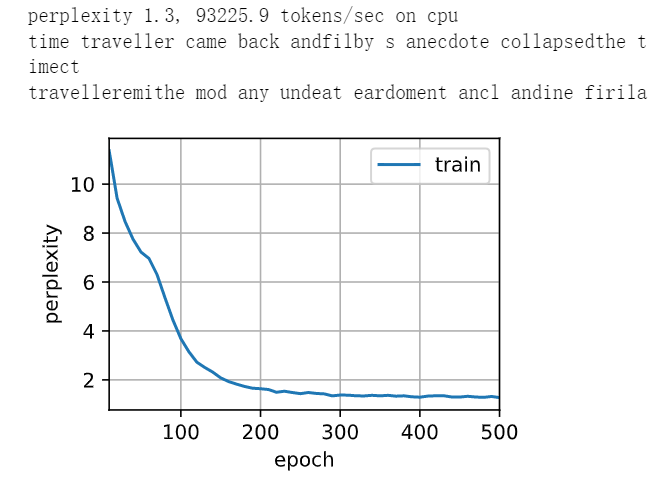
    print(f'困惑度 {ppl:.1f}, {speed:.1f} 词元/秒 {str(device)}')
    print(predict('time traveller'))
    print(predict('traveller'))
num_epochs, lr = 500, 1
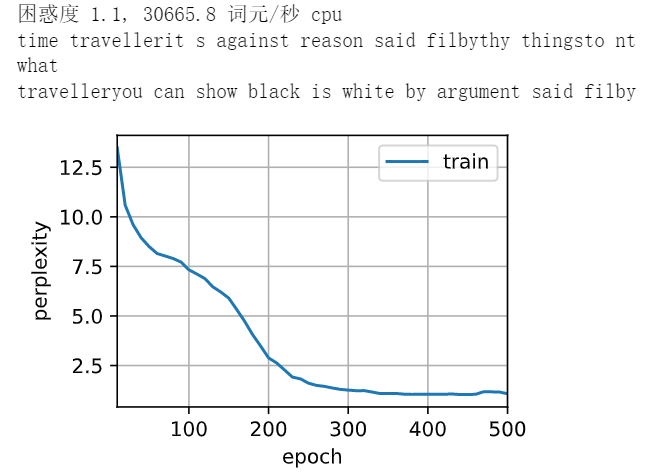
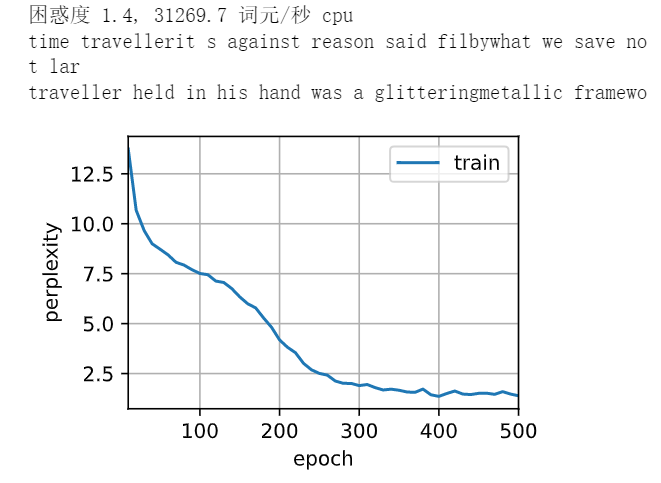
train_ch8(net, train_iter, vocab, lr, num_epochs, d2l.try_gpu())
#结果证明可以预测出比较正确的词,但是不能预测讲得通的句子
net = RNNModelScratch(len(vocab), num_hiddens, d2l.try_gpu(), get_params,
                      init_rnn_state, rnn)
train_ch8(net, train_iter, vocab, lr, num_epochs, d2l.try_gpu(),
          use_random_iter=True)
简洁实现
功能重复
import torch
from torch import nn
from torch.nn import functional as F
from d2l import torch as d2l

batch_size, num_steps = 32, 35
train_iter, vocab = d2l.load_data_time_machine(batch_size, num_steps)

num_hiddens = 256
#直接调用RNN类,输入大小,隐藏层大小
rnn_layer = nn.RNN(len(vocab), num_hiddens)
# 自动初始化H[0]为全零

state = torch.zeros((1, batch_size, num_hiddens))
#加了一个维度
state.shape

X = torch.rand(size=(num_steps, batch_size, len(vocab)))
Y, state_new = rnn_layer(X, state)
Y.shape, state_new.shape
#num_steps, batch_size, num_hiddens
#pyTorch 的RNN Layer只包括隐藏层,但不包括输出层
用类封装RNN+Linear
class RNNModel(nn.Module):
    """循环神经网络模型"""
    def __init__(self, rnn_layer, vocab_size, **kwargs):
        super(RNNModel, self).__init__(**kwargs)
        self.rnn = rnn_layer
        self.vocab_size = vocab_size
        self.num_hiddens = self.rnn.hidden_size
        # 如果RNN是双向的(之后将介绍),num_directions应该是2,否则应该是1
        if not self.rnn.bidirectional:
            self.num_directions = 1
            self.linear = nn.Linear(self.num_hiddens, self.vocab_size)
        else:
            self.num_directions = 2
            self.linear = nn.Linear(self.num_hiddens * 2, self.vocab_size)

    def forward(self, inputs, state):
        X = F.one_hot(inputs.T.long(), self.vocab_size)
        X = X.to(torch.float32)
        Y, state = self.rnn(X, state)
        # 全连接层首先将Y的形状改为(时间步数*批量大小,隐藏单元数)
        # 它的输出形状是(时间步数*批量大小,词表大小)。
        output = self.linear(Y.reshape((-1, Y.shape[-1])))
        return output, state

    def begin_state(self, device, batch_size=1):
        if not isinstance(self.rnn, nn.LSTM):
            # nn.GRU以张量作为隐状态
            return  torch.zeros((self.num_directions * self.rnn.num_layers,
                                 batch_size, self.num_hiddens),
                                device=device)
        else:
            # nn.LSTM以元组作为隐状态
            return (torch.zeros((
                self.num_directions * self.rnn.num_layers,
                batch_size, self.num_hiddens), device=device),
                    torch.zeros((
                        self.num_directions * self.rnn.num_layers,
                        batch_size, self.num_hiddens), device=device))
训练
device = d2l.try_gpu()
net = RNNModel(rnn_layer, vocab_size=len(vocab))
net = net.to(device)
d2l.predict_ch8('time traveller', 10, net, vocab, device)

num_epochs, lr = 500, 1
d2l.train_ch8(net, train_iter, vocab, lr, num_epochs, device)
#框架的RNN更快一些,因为自定义是多次小矩阵乘法,框架是大矩阵运算