
D2L-48 机器翻译数据集
Published:
本文介绍机器翻译中的平行语料处理,展示文本规范化、分词、词表构建、序列截断与填充,以及有效长度和小批量数据的组织方式。
🎦 本节课程视频地址 👇
此后四节都是对机器翻译进行的讲解
预处理
import os
import torch
from d2l import torch as d2l

d2l.DATA_HUB['fra-eng'] = (d2l.DATA_URL + 'fra-eng.zip',
                           '94646ad1522d915e7b0f9296181140edcf86a4f5')

def read_data_nmt():
    """载入“英语-法语”数据集"""
    data_dir = d2l.download_extract('fra-eng')
    with open(os.path.join(data_dir, 'fra.txt'), 'r',
             encoding='utf-8') as f:
        return f.read()

raw_text = read_data_nmt()
#把读取的内容赋值给raw_text
print(raw_text[:75])

def preprocess_nmt(text):
    """预处理“英语-法语”数据集"""
    def no_space(char, prev_char):
        return char in set(',.!?') and prev_char != ' '
        # 如果是标调符号而且前面不是空格

    text = text.replace('\u202f', ' ').replace('\xa0', ' ').lower()
    # str.replace(old, new[, max])
    # 替换新旧字符方法
    # 返回新字符串
    # 使用小写字母替换大写字母
    # 使用空格替换不间断空格以及各种编码(半角、全角)格式的空格
    # 也就是统一形形色色空格的形式
    out = [' ' + char if i > 0 and no_space(char, text[i - 1]) else char
           for i, char in enumerate(text)]
    #遍历文本,给所有标点前加空格
    #空格也会作为一个字符被遍历
    return ''.join(out)
    #用前面的字符连接后面的字符串序列
text = preprocess_nmt(raw_text)
print(text[:80])
词元化
def tokenize_nmt(text, num_examples=None):
    """词元化“英语-法语”数据数据集"""
    source, target = [], []
    for i, line in enumerate(text.split('\n')):
        if num_examples and i > num_examples:
            break
        parts = line.split('\t')
        if len(parts) == 2:
            source.append(parts[0].split(' '))
            target.append(parts[1].split(' '))
    return source, target

source, target = tokenize_nmt(text)
source[:6], target[:6]

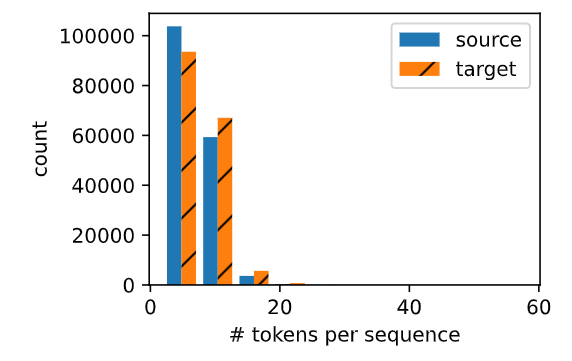
def show_list_len_pair_hist(legend, xlabel, ylabel, xlist, ylist):
    """绘制列表长度对的直方图"""
    d2l.set_figsize()
    _, _, patches = d2l.plt.hist(
        [[len(l) for l in xlist], [len(l) for l in ylist]]) #source/target每个句子(数组元素)的长度
    d2l.plt.xlabel(xlabel) # tokens per sequence
    d2l.plt.ylabel(ylabel) # count
    for patch in patches[1].patches:
        patch.set_hatch('/')
    d2l.plt.legend(legend) #['source', 'target']

show_list_len_pair_hist(['source', 'target'], '# tokens per sequence',
                        'count', source, target);
构建词汇表和定长
src_vocab = d2l.Vocab(source, min_freq=2,
                      reserved_tokens=['<pad>', '<bos>', '<eos>'])
#<pad>填充
#<bos>begin of sentence
#<eos>end of sentence
#min_freq频率小于2则舍弃
len(src_vocab)
def truncate_pad(line, num_steps, padding_token):
    """把每个句子变成等同的长度"""
    if len(line) > num_steps:
        return line[:num_steps]  # 多则截断
    return line + [padding_token] * (num_steps - len(line))  # 填少则充

truncate_pad(src_vocab[source[0]], 10, src_vocab['<pad>'])
#vocab()返回的是词汇在其中的索引
#通过定义__getitem__()可以索引
#<unk>=0,<pad>=1,<bos>=2,<eos>=3
def build_array_nmt(lines, vocab, num_steps): #lines=[source]/[target]
    """将机器翻译的文本序列转换成小批量"""
    lines = [vocab[l] for l in lines]
    lines = [l + [vocab['<eos>']] for l in lines] #句子末尾加<eos>标识符
    array = torch.tensor([truncate_pad(
        l, num_steps, vocab['<pad>']) for l in lines]) #定长
    # array是所有行组成的张量
    valid_len = (array != vocab['<pad>']).type(torch.int32).sum(1) #先bool,再变int,最后统计
    #1表示按列求和
    return array, valid_len
程序封装
#集成功能,实现输入从预处理文件到输出迭代器的张量
def load_data_nmt(batch_size, num_steps, num_examples=600):
    """返回翻译数据集的迭代器和词表"""
    text = preprocess_nmt(read_data_nmt())
    source, target = tokenize_nmt(text, num_examples)
    src_vocab = d2l.Vocab(source, min_freq=2,
                          reserved_tokens=['<pad>', '<bos>', '<eos>'])
    tgt_vocab = d2l.Vocab(target, min_freq=2,
                          reserved_tokens=['<pad>', '<bos>', '<eos>'])
    src_array, src_valid_len = build_array_nmt(source, src_vocab, num_steps)
    tgt_array, tgt_valid_len = build_array_nmt(target, tgt_vocab, num_steps)
    data_arrays = (src_array, src_valid_len, tgt_array, tgt_valid_len)
    data_iter = d2l.load_array(data_arrays, batch_size)
    #写load的时候数据一定是张量
    return data_iter, src_vocab, tgt_vocab

train_iter, src_vocab, tgt_vocab = load_data_nmt(batch_size=2, num_steps=8) # batch_size=2 读两个句子
for X, X_valid_len, Y, Y_valid_len in train_iter:
    print('X:', X.type(torch.int32))
    print('X的有效长度:', X_valid_len)
    print('Y:', Y.type(torch.int32))
    print('Y的有效长度:', Y_valid_len)
    break