
序列到序列学习Seq2Seq
Published:
本文介绍序列到序列学习在机器翻译中的应用,讲解编码器与解码器的连接、训练和预测过程,并给出 Seq2Seq 模型及翻译质量评估的实现。
🎦 本节课程视频地址 👇
序列到序列
- 给定一个源语言的句子,自动翻译成目标语言
- 这两个句子可以有不同的长度
Seq2Seq
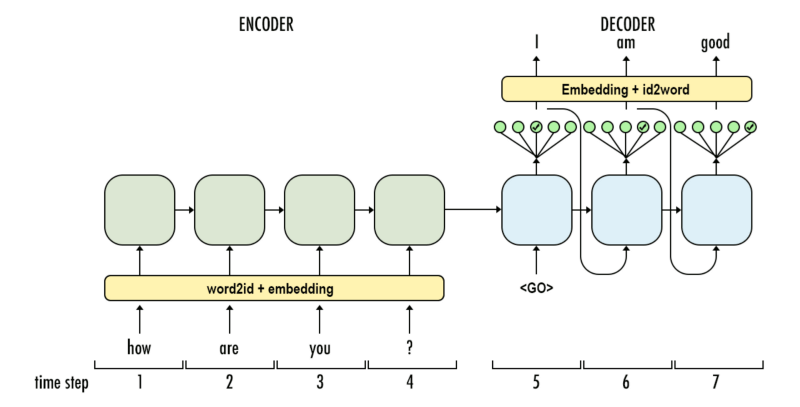
- 编码器是一个RNN,读取输入句子
- 可以是双向
- 解码器使用另外一个RNN来输出
- 从
<bos>起始到<eos>结束,长度可以不一致 - 上一刻的输出作为下一刻的输入
- 从任意长度到任意长度
- 从
编码器-解码器细节
- 编码器是没有输出的RNN
- 编码器最后时间步的隐状态用作解码器的初始隐状态
训练
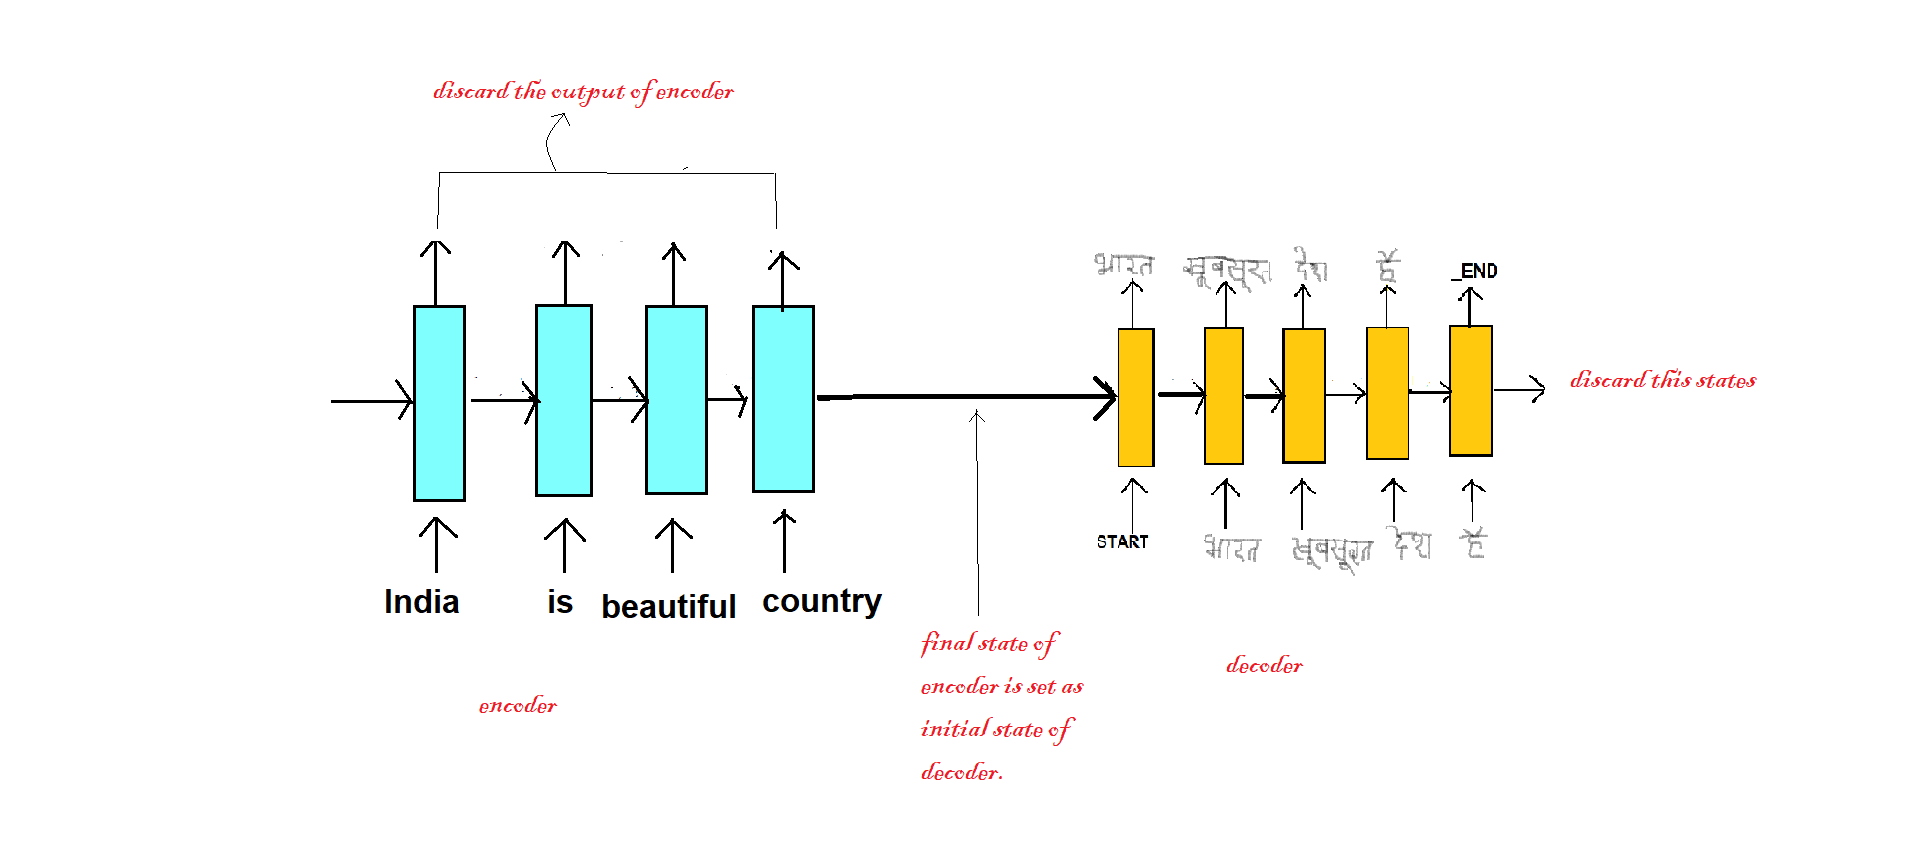
- 训练时解码器使用目标句子作为输入
- 即便翻译错了下一个时刻的输入也是正确的
- 推理用上一刻的输入进行预测,所以不用从外围导入输入。
衡量生成序列的好坏的BLEU
- \(p_n\) 是预测中所有的 n-gram 的精度
- 标签序列 \(A B C D E F\) 和预测序列 \(A B B C D\),有 \(p_1=4/5\),\(p_2=3/4\),\(p_3=1/3\),\(p_4=0\)
- uni-gram 预测一个词
- bi-gram 预测两个连续的词
- 标签里所有目标长度序列(n-gram)在预测序列出现的概率
- 标签序列 \(A B C D E F\) 和预测序列 \(A B B C D\),有 \(p_1=4/5\),\(p_2=3/4\),\(p_3=1/3\),\(p_4=0\)
- BLEU定义
- 越大越好,\(\max(BLEU)=1\)
- 内括号-惩罚过短的预测
- 累乘-长匹配有高权重
总结
- Seq2seq从一个句子生成另一个句子
- 编码器和解码器都是RNN
- 将编码器最后时间隐状态来初始解码器隐状态来完成信息传递
- 常用BLEU来衡量生成序列的好坏
代码实现
定义编码
import collections
import math
import torch
from torch import nn
from d2l import torch as d2l

class Seq2SeqEncoder(d2l.Encoder):
    """用于序列到序列学习的循环神经网络编码器"""
    def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
                 dropout=0, **kwargs):
        super(Seq2SeqEncoder, self).__init__(**kwargs)
        self.embedding = nn.Embedding(vocab_size, embed_size)
        ##vocab_size是source
        #nn.Embedding(num_embeddings, embedding_dim)
        #This module is often used to store word embeddings and retrieve them using indices. The input to the module is a list of indices,
        #and the output is the corresponding word embeddings.
        #arg词典大小、生成词向量的维度
        #输入字符串在字典里的索引,返回词向量
        self.rnn = nn.GRU(embed_size, num_hiddens, num_layers,
                          dropout=dropout)
        #Encoder不需要输出层

    def forward(self, X, *args):
        X = self.embedding(X)
        # 输出'X'的形状:(batch_size,num_steps,embed_size)
        X = X.permute(1, 0, 2)
        # 做转置
        output, state = self.rnn(X)
        # output是每一个时间步隐藏层的输出:containing the output features (h_t) from the last layer of the RNN, for each t
        # output的形状:(num_steps,batch_size,num_hiddens)
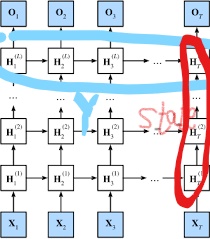
        # state是最后一个时间步每个层的隐藏层,containing the final hidden state for each element in the batch
        # state[0]的形状:(num_layers,batch_size,num_hiddens)
        return output, state

encoder = Seq2SeqEncoder(vocab_size=10, embed_size=8, num_hiddens=16,
                         num_layers=2)
encoder.eval()
X = torch.zeros((4, 7), dtype=torch.long)
output, state = encoder(X)
output.shape

state.shape
定义解码
class Seq2SeqDecoder(d2l.Decoder):
    """用于序列到序列学习的循环神经网络解码器"""
    def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
                 dropout=0, **kwargs):
        super(Seq2SeqDecoder, self).__init__(**kwargs)
        self.embedding = nn.Embedding(vocab_size, embed_size)
        #vocab_size是target的
        self.rnn = nn.GRU(embed_size + num_hiddens, num_hiddens, num_layers,
                          dropout=dropout)
        #假设en/de的num_hiddens相同
        self.dense = nn.Linear(num_hiddens, vocab_size)
        #有一个全连接输出层

    def init_state(self, enc_outputs, *args):
        return enc_outputs[1]
        #enc_outputs是前方的(output, state)
        #[1]是state,作为初始隐藏层

    def forward(self, X, state):
        # 输出'X'的形状:(batch_size,num_steps,embed_size)
        X = self.embedding(X).permute(1, 0, 2)

        context = state[-1].repeat(X.shape[0], 1, 1)
        #state[-1]是最后一层的输出(batch_size, num_hiddens)
        #repeat(dims)沿着维度复制, X.shape[0]=num_steps
        #context的形状(num_steps, batch_size, num_hiddens)
        #广播context,使其具有与X相同的num_steps
        X_and_context = torch.cat((X, context), 2)
        #(num_steps, batch_size, embed_size+num_hiddens)
        #在每个输入的长度与最后隐藏层长度相连接
        output, state = self.rnn(X_and_context, state)
        output = self.dense(output).permute(1, 0, 2)
        # output的形状:(batch_size,num_steps,vocab_size)
        # state[0]的形状:(num_layers,batch_size,num_hiddens)
        return output, state

decoder = Seq2SeqDecoder(vocab_size=10, embed_size=8, num_hiddens=16,
                         num_layers=2)
decoder.eval()
state = decoder.init_state(encoder(X)) # (2, 4, 16)
output, state = decoder(X, state) #(4, 7, 10) (2, 4, 16)
# 相当于X是字符串的token,要先embed+num_hiddens向量化
# decoder的输入只需要batchsize和encode的输入相同
# 即便num_steps不同,也可以进行预测
output.shape, state.shape
损失屏蔽
def sequence_mask(X, valid_len, value=0):
    """
    在序列中屏蔽不相关的项
    输入tokens和valid_len,把每个num_step超出valid_len处的token屏蔽(换为0)
    """
    maxlen = X.size(1)
    # num_steps
    mask = torch.arange((maxlen), dtype=torch.float32,
                        device=X.device)[None, :] < valid_len[:, None]
    # 出现None(numpy, tensor可以,list等不可以)相当于增加了一个维度
    X[~mask] = value
    # ~代表取反
    return X

X = torch.tensor([[1, 2, 3], [4, 5, 6]])
sequence_mask(X, torch.tensor([1, 2]))
# X.size(1)=3
#torch.arange((maxlen)).shape=(3,)
#[None, :].shape=(1, 3)
#valid.shape=(2,)
#[:, None].shape=(2, 1)
#广播做比较
#[~]取反,把原先的False变为True,然后赋值为0
定义损失
class MaskedSoftmaxCELoss(nn.CrossEntropyLoss):
    """带遮蔽的softmax交叉熵损失函数:把填充的内容屏蔽掉,不对其做预测"""

    # pred的形状:(batch_size,num_steps,vocab_size)
    # label的形状:(batch_size,num_steps)
    # valid_len的形状:(batch_size,)
    def forward(self, pred, label, valid_len):
        weights = torch.ones_like(label)
        #ones_like生成对应形状(label.shape)的全1向量
        weights = sequence_mask(weights, valid_len)
        #把weights里超出有效长度的变0
        self.reduction='none'
        #不做reduction,返回的就是张量
        unweighted_loss = super(MaskedSoftmaxCELoss, self).forward(
            pred.permute(0, 2, 1), label)
        #原本做交叉熵的方式
        weighted_loss = (unweighted_loss * weights).mean(dim=1)
        #现在再按行做平均(把vocab_size调换到了行的维度)
        return weighted_loss
    #既然重定义了forward(),就必须把每个环节都定义了

loss = MaskedSoftmaxCELoss()
loss(torch.ones(3, 4, 10), torch.ones((3, 4), dtype=torch.long),
     torch.tensor([4, 2, 0]))
定义训练
def train_seq2seq(net, data_iter, lr, num_epochs, tgt_vocab, device):
    """训练序列到序列模型"""
    def xavier_init_weights(m):
        #初始化权重
        if type(m) == nn.Linear:
            nn.init.xavier_uniform_(m.weight)
        if type(m) == nn.GRU:
            for param in m._flat_weights_names:
                if "weight" in param:
                    nn.init.xavier_uniform_(m._parameters[param])
                    #任何以下划线开头的内容都视为存在访问限制

    net.apply(xavier_init_weights)
    net.to(device)
    optimizer = torch.optim.Adam(net.parameters(), lr=lr)
    loss = MaskedSoftmaxCELoss()
    net.train()
    #Sets the module in training mode
    animator = d2l.Animator(xlabel='epoch', ylabel='loss',
                     xlim=[10, num_epochs])
    for epoch in range(num_epochs):
        timer = d2l.Timer()
        metric = d2l.Accumulator(2)  # 训练损失总和,词元数量
        for batch in data_iter:
            optimizer.zero_grad() #source and target
            X, X_valid_len, Y, Y_valid_len = [x.to(device) for x in batch]
            bos = torch.tensor([tgt_vocab['<bos>']] * Y.shape[0],
                          device=device).reshape(-1, 1)
            #reserved_vocab=['<pad>', '<bos>', '<eos>']
            #Y.shape[0]=bacth_size
            #变成一列
            dec_input = torch.cat([bos, Y[:, :-1]], 1)
            #按列把bos的索引和target输入相连接,舍去最后一个元素<eos>
            Y_hat, _ = net(X, dec_input, X_valid_len) #X_valid_len并没有实际用到
            l = loss(Y_hat, Y, Y_valid_len)
            l.sum().backward()      # 损失函数的标量进行“反向传播”
            d2l.grad_clipping(net, 1)
            num_tokens = Y_valid_len.sum()
            optimizer.step()
            with torch.no_grad():
                metric.add(l.sum(), num_tokens)
        if (epoch + 1) % 10 == 0:
            animator.add(epoch + 1, (metric[0] / metric[1],))
    print(f'loss {metric[0] / metric[1]:.3f}, {metric[1] / timer.stop():.1f} '
        f'tokens/sec on {str(device)}')

embed_size, num_hiddens, num_layers, dropout = 32, 32, 2, 0.1
batch_size, num_steps = 64, 10
#可以认为是一个长度为20的RNN
#embed_size不再是独热的编码,所以没那么长了
lr, num_epochs, device = 0.005, 300, d2l.try_gpu()

train_iter, src_vocab, tgt_vocab = d2l.load_data_nmt(batch_size, num_steps)
encoder = Seq2SeqEncoder(len(src_vocab), embed_size, num_hiddens, num_layers,
                        dropout)
decoder = Seq2SeqDecoder(len(tgt_vocab), embed_size, num_hiddens, num_layers,
                        dropout)
net = d2l.EncoderDecoder(encoder, decoder)
train_seq2seq(net, train_iter, lr, num_epochs, tgt_vocab, device)
定义预测
def predict_seq2seq(net, src_sentence, src_vocab, tgt_vocab, num_steps,
                    device, save_attention_weights=False):
    """序列到序列模型的预测"""
    #num_steps是预测的目标长度(10)

    net.eval()
    #在预测时将net设置为评估模式
    src_tokens = src_vocab[src_sentence.lower().split(' ')] + [
        src_vocab['<eos>']]
    #把要预测的文本tokenize
    enc_valid_len = torch.tensor([len(src_tokens)], device=device)
    src_tokens = d2l.truncate_pad(src_tokens, num_steps, src_vocab['<pad>'])

    enc_X = torch.unsqueeze(
        torch.tensor(src_tokens, dtype=torch.long, device=device), dim=0)
    # 添加批量轴
    enc_outputs = net.encoder(enc_X, enc_valid_len)
    dec_state = net.decoder.init_state(enc_outputs, enc_valid_len)
    #把encode的最后隐藏层传入decode中作为初态

    dec_X = torch.unsqueeze(torch.tensor(
        [tgt_vocab['<bos>']], dtype=torch.long, device=device), dim=0)
    # 做<bos>开头添加批量轴
    #一次只预测一句话,所以<bos>只用加一个
    # 是一个二维张量
    output_seq, attention_weight_seq = [], []
    for _ in range(num_steps):
        Y, dec_state = net.decoder(dec_X, dec_state)
        # 我们使用具有预测最高可能性的词元,作为解码器在下一时间步的输入
        dec_X = Y.argmax(dim=2)
        #Y.shape=(batch_size,num_steps,vocab_size)
        #预测最大处在词典里的对应下标
        pred = dec_X.squeeze(dim=0).type(torch.int32).item()
        #Tensor.item() → number
        #.item()可以拿一个元素的张量,本质就是一个scalar,只是去了括号
        if save_attention_weights:
            attention_weight_seq.append(net.decoder.attention_weights)
        if pred == tgt_vocab['<eos>']:
        # 一旦序列结束词元被预测,输出序列的生成就完成了
            break
        output_seq.append(pred)
    return ' '.join(tgt_vocab.to_tokens(output_seq)), attention_weight_seq
定义BLEU
def bleu(pred_seq, label_seq, k):   #k是n-gram
    """计算BLEU"""
    pred_tokens, label_tokens = pred_seq.split(' '), label_seq.split(' ')
    len_pred, len_label = len(pred_tokens), len(label_tokens)
    score = math.exp(min(0, 1 - len_label / len_pred))
    for n in range(1, k + 1):
        num_matches, label_subs = 0, collections.defaultdict(int)
        #字典键不存在时返回默认值的格式(int)的0.
        #并且创造该键值对
        for i in range(len_label - n + 1):
            #为label里每个出现的gram建立字典键值对并计数
            label_subs[' '.join(label_tokens[i: i + n])] += 1
        for i in range(len_pred - n + 1):
            #每个gram出现的在字典里的值都大于0
            #判断条件成立匹配数就+1
            #同时字典里的计数减1
            #如果多出来的不会被算作匹配
            if label_subs[' '.join(pred_tokens[i: i + n])] > 0:
                num_matches += 1
                label_subs[' '.join(pred_tokens[i: i + n])] -= 1
        score *= math.pow(num_matches / (len_pred - n + 1), math.pow(0.5, n))
    return score

engs = ['go .', "i lost .", 'he\'s calm .', 'i\'m home .']
fras = ['va !', 'j\'ai perdu .', 'il est calme .', 'je suis chez moi .']
for eng, fra in zip(engs, fras):
    translation, attention_weight_seq = predict_seq2seq(
        net, eng, src_vocab, tgt_vocab, num_steps, device)
    print(f'{eng} => {translation}, bleu {bleu(translation, fra, k=2):.3f}')