注意力分数
Published:
本文介绍注意力分数的计算与掩码 Softmax,对比加性注意力和缩放点积注意力,并给出相应的 PyTorch 实现与权重可视化示例。
\[f(x)=\sum_{i=1}^nsoftmax\left(-{1\over2}((x-x_i))^2\right)y_i\]- 其中,被normalize之前的 \((-{1\over2}((x-x_i))^2\),称之为注意力分数 (attention scoring function)
拓展到高维度
- 假设 query \({\bf q}\in\mathbb R^n\),\(m\) 对 key-value \((\bf k_1,v_1),...\),这里 \({\bf k_i}\in\mathbb R^k\),\({\bf v_i}\in\mathbb R^v\)
注意力池化层:
\[f({\bf q,(k_1,v_1),...,(k_m,v_m)})=\sum_{i=1}^m\alpha({\bf q,k_i}){\bf v_i}\in\mathbb R^v\] \[\alpha({\bf q,k_i})=softmax(a({\bf q,k_i}))={\exp(a({\bf q,k_i}))\over\sum_{j=1}^m\exp(a({\bf q,k_j})}\in\mathbb R\]
Additive Attention
- 可学参数:\({\bf W_k}\in\mathbb R^{h\times k},{\bf W_q}\in\mathbb R^{h\times q},{\bf w_v}\in\mathbb R^h\) \(a({\bf k,q})={\bf w_v}^Ttanh({\bf W_kk+W_qq })\)
- 等价于将 key 和 value 合并起来后放入到一个隐藏层大小为 h 输出大小为1的单隐藏层MLP
- 输出一个标量
- \(\bf q,k,v\) 可以是不同长度
- 拓展维度:\({\bf Q}\in\mathbb R^{n\times q},\ {\bf K}\in\mathbb R^{m\times k},\ V^{m\times v}\)
- \[a({\bf K,Q})={\bf w_v}^Ttanh({\bf KW_k^T+QW_q^T })\]
Scaled Dot_product Attention
- 如果 query 和 key 都是同样的长度,\({\bf q,k_i}\in\mathbb R^d\),那么可以: \(a({\bf q_i,k})=<{\bf q,k_i}>/\sqrt d\)
- 除以根号 d 使对长度不敏感
- 向量化版本
- \[{\bf Q}\in\mathbb R^{n\times d},\ {\bf K}\in\mathbb R^{m\times d},\ V^{m\times v}\]
- 注意力分数:\(a({\bf Q,K})={\bf QK}^T/\sqrt d\in\mathbb R^{n \times m}\)
- 注意力池化:\(f=softmax(a({\bf Q,K})){\bf V}\in\mathbb R^{n \times v}\)
- 有 \(n\) 个 query, \(m\) 个 key,每个 key 有 \(v\) 个 value
总结
- 注意力分数是 query 和 key 的相似度,注意力权重是分数的softmax结果
- 两种常见的分数计算:
- 将 query 和 key 合并起来进入一个单输出单隐藏层的MLP
- 直接将 query 和 key 做内积
代码实现
定义padding屏蔽的辅助函数
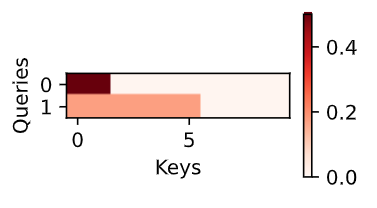
d2l.show_heatmaps(attention.attention_weights.reshape((1, 1, 2, 10)),
                  xlabel='Keys', ylabel='Queries')

def masked_softmax(X, valid_lens):
    """通过在最后一个轴上掩蔽元素来执行softmax操作"""
    # X:3D张量,valid_lens:1D或2D张量
    if valid_lens is None:
        return nn.functional.softmax(X, dim=-1)
    else:
        shape = X.shape
        if valid_lens.dim() == 1:
        # dim(): Returns the number of dimensions of self tensor.
        # dim=1,a vector
            valid_lens = torch.repeat_interleave(valid_lens, shape[1])
            # 复制X行数的validlens shape=(shape[1]*len(valid_lens,)
        else:
            valid_lens = valid_lens.reshape(-1)
        # 维度大于1,就拉成一行
        X = d2l.sequence_mask(X.reshape(-1, shape[-1]), valid_lens,
                              value=-1e6)
        # 把X变为二维按行堆积
        # 把超出len的替换成非常大的负数
        return nn.functional.softmax(X.reshape(shape), dim=-1)
        # 维度可能会大于二,所以对指定对最后的列做softmax

masked_softmax(torch.rand(2, 2, 4), torch.tensor([2, 3]))

masked_softmax(torch.rand(2, 2, 4), torch.tensor([[1, 3], [2, 4]]))
加性注意力
class AdditiveAttention(nn.Module):
    """加性注意力"""
    def __init__(self, key_size, query_size, num_hiddens, dropout, **kwargs):
        super(AdditiveAttention, self).__init__(**kwargs)
        self.W_k = nn.Linear(key_size, num_hiddens, bias=False)
        self.W_q = nn.Linear(query_size, num_hiddens, bias=False)
        self.w_v = nn.Linear(num_hiddens, 1, bias=False)
        self.dropout = nn.Dropout(dropout)

    def forward(self, queries, keys, values, valid_lens):
        # valid_lens代表对于每一个query有效的key-value pair
        queries, keys = self.W_q(queries), self.W_k(keys)
        #(batch_size, num_quaries, num_hiddens)
        #(bacth_size, num_keys, num_hiddens)
        #中间维度不相同
        features = queries.unsqueeze(2) + keys.unsqueeze(1)
        #(batch_size, num_quaries, 1, num_hiddens)
        #(bacth_size, 1, num_keys, num_hiddens)
        #(bacth_size, num_quaries, num_keys, num_hiddens)
        features = torch.tanh(features)
        scores = self.w_v(features).squeeze(-1)
        #和self.w做矩阵乘法长度h被消除,拿掉空维度
        #(batch_size, num_quaries, num_keys)
        self.attention_weights = masked_softmax(scores, valid_lens)
        #过滤掉不需要的padding
        return torch.bmm(self.dropout(self.attention_weights), values)
        #用dropot随机把更多的权重变为0


queries, keys = torch.normal(0, 1, (2, 1, 20)), torch.ones((2, 10, 2))
# (2, 1, 20),(2, 10, 2)
values = torch.arange(40, dtype=torch.float32).reshape(1, 10, 4).repeat(
    2, 1, 1)
# (2, 10, 4)
valid_lens = torch.tensor([2, 6])

attention = AdditiveAttention(key_size=2, query_size=20, num_hiddens=8,
                              dropout=0.1)
# (2, 1, 8),(2, 10, 8)
# (2, 1, 10 ,8)
# (2, 1, 10)
# (2, 1, 4)
attention.eval()
attention(queries, keys, values, valid_lens)

d2l.show_heatmaps(attention.attention_weights.reshape((1, 1, 2, 10)),
                  xlabel='Keys', ylabel='Queries')
#valid_lens.shape=(2, 6)
缩放点积注意力
class DotProductAttention(nn.Module):
    """缩放点积注意力"""
    def __init__(self, dropout, **kwargs):
        super(DotProductAttention, self).__init__(**kwargs)
        self.dropout = nn.Dropout(dropout)

    def forward(self, queries, keys, values, valid_lens=None):
    # queries的形状:(batch_size,num_queries,d)
    # keys的形状:(batch_size,num_kvpairs,d)
    # values的形状:(batch_size,num_kvpairs,d_values)
    # valid_lens的形状:(batch_size,)或者(batch_size,num_queries)
        d = queries.shape[-1]
        scores = torch.bmm(queries, keys.transpose(1,2)) / math.sqrt(d)
        #(batch_size,num_queries,num_kvpairs)
        self.attention_weights = masked_softmax(scores, valid_lens)
        return torch.bmm(self.dropout(self.attention_weights), values)
        #(batch_size,num_queries,d_values)

queries = torch.normal(0, 1, (2, 1, 2))
#keys=(2, 10, 2),values=(2, 10, 4)
attention = DotProductAttention(dropout=0.5)
#(2, 1, 4)
attention.eval()
attention(queries, keys, values, valid_lens)

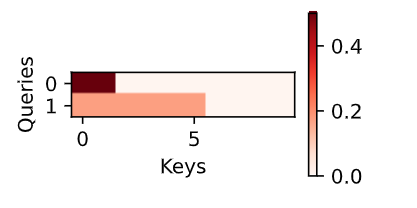
d2l.show_heatmaps(attention.attention_weights.reshape((1, 1, 2, 10)),
                  xlabel='Keys', ylabel='Queries')
#超出valid_len的部分没有权重