
转置卷积
Published:
本文介绍转置卷积如何增大特征图尺寸,说明其基本计算过程,并通过代码比较转置卷积、普通卷积和矩阵运算之间的关系。
🎦 本节课程视频地址 👇
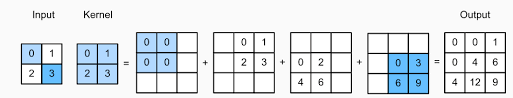
转置卷积(Transposed Convolution)
- 卷积不会增大输入的高宽,通常要么不变、要么减半
- 语义分割需要在像素级别评估
- 转置卷积则可以用来增大输入高宽
为什么称之为“转置”
- 对于卷积 \(Y=X\star W\)
- 可以对 \(W\) 构造一个 \(V\) ,使得卷积等价于矩阵乘法 \(Y\prime=VX\prime\)
- 这里 \(Y\prime,\ X\prime\) 是 \(Y,\ X\) 对应的向量版本
- \[m = (m, n) \times n\]
- 早期就是这么做的
- 转置卷积则等价于 \(Y\prime=V^TX\prime\)
- 如果卷积将输入从 \((h, w)\) 变成了 \((h\prime, w\prime)\)
- 同样超参数的转置卷积则从 \((h\prime, w\prime)\) 变回 \((h, w)\),逆变换关系
- \[n = (n, m) \times m\]
- 交换了维度,原本的卷积维度减小变成了转置维度增加
代码实现
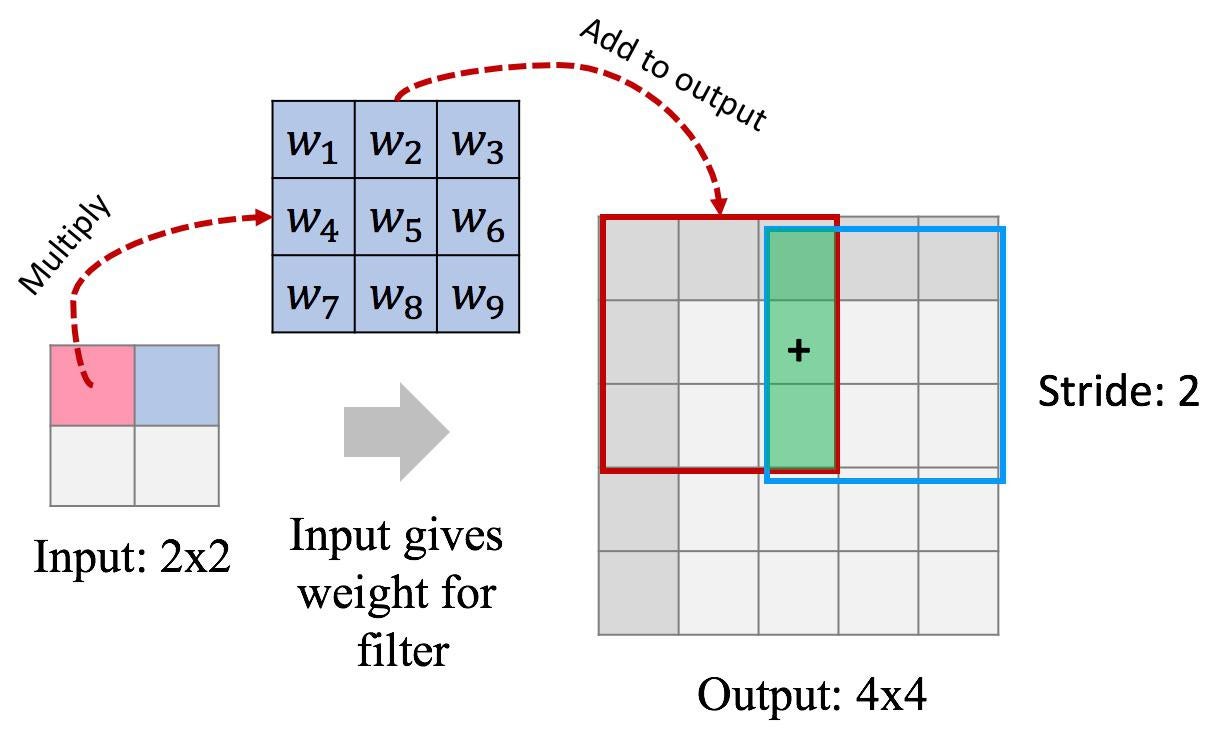
对于一个张量 \(X\),转置卷积的输出 \(h_Y=h_k+(h_X-1)\times stride - 2\times padding\\ w_Y=w_k+(w_X-1)\times stride - 2\times padding\)
import torch
from torch import nn
from d2l import torch as d2l

#自定义实现
def trans_conv(X, K):
    h, w = K.shape
    Y = torch.zeros((X.shape[0] + h - 1, X.shape[1] + w - 1))
    print(Y)
    for i in range(X.shape[0]):
        for j in range(X.shape[1]):
            Y[i: i + h, j: j + w] += X[i, j] * K
            #对矩阵的一个方阵重新赋值
    return Y


#用pyTorch内置模块
X, K = X.reshape(1, 1, 2, 2), K.reshape(1, 1, 2, 2)
tconv = nn.ConvTranspose2d(1, 1, kernel_size=2, bias=False)
tconv.weight.data = K
#设置核的值
tconv(X)
填充和步幅
#填充
tconv = nn.ConvTranspose2d(1, 1, kernel_size=2, padding=1, bias=False)
tconv.weight.data = K
tconv(X)
#在输出上作用一个逆向填充

#步幅
tconv = nn.ConvTranspose2d(1, 1, kernel_size=2, stride=2, bias=False)
tconv.weight.data = K
tconv(X)
#输出高宽 h/w +stride * (shape[0]/[1] - 1)

X = torch.rand(size=(1, 10, 16, 16))
conv = nn.Conv2d(10, 20, kernel_size=5, padding=2, stride=3)
tconv = nn.ConvTranspose2d(20, 10, kernel_size=5, padding=2, stride=3)
tconv(conv(X)).shape == X.shape
#输出高宽 h/w +stride * (shape[0]/[1] - 1) - padding * 2
原理验证
X = torch.arange(9.0).reshape(3, 3)
K = torch.tensor([[1.0, 2.0], [3.0, 4.0]])
Y = d2l.corr2d(X, K)
Y

def kernel2matrix(K):
    k, W = torch.zeros(5), torch.zeros((4, 9))

    k[:2], k[3:5] = K[0, :], K[1, :]
    # k = [1., 2., 0., 3., 4.]
    W[0, :5], W[1, 1:6], W[2, 3:8], W[3, 4:] = k, k, k, k

    return W

W = kernel2matrix(K)
W

Y == torch.matmul(W, X.reshape(-1)).reshape(2, 2)

Z = trans_conv(Y, K)
Z == torch.matmul(W.T, Y.reshape(-1)).reshape(3, 3)