
Kaggle 实战 - CIFAR-10
Published:
本文以 Kaggle CIFAR-10 图像分类任务为例,介绍数据组织、训练与验证集划分、数据增广和模型训练,展示从读取比赛数据到生成预测结果的实践流程。
🎦 本节课程视频地址 👇
CIFAR-10数据集
之前几节中,我们一直在使用深度学习框架的高级 API 直接获取张量格式的图像数据集。 但是在实践中,图像数据集通常以图像文件的形式出现。 在本节中,我们将从原始图像文件开始,然后逐步组织、读取并将它们转换为张量格式。
我们将数据划分训练集、验证集和测试集。在训练集上训练模型,在验证集上评估模型,一旦找到的最佳的参数,就在测试集上最后测试一次,测试集上的误差作为泛化误差的近似。
比赛数据集分为训练集和测试集,其中训练集包含 50000 张、测试集包含 300000 张图像。 在测试集中,10000 张图像将被用于评估,而剩下的 290000 张图像将不会被进行评估,包含它们只是为了防止手动标记测试集并提交标记结果。 两个数据集中的图像都是 png 格式,高度和宽度均为 32 像素并有三个颜色通道(RGB)。 这些图片共涵盖 10 个类别:飞机、汽车、鸟类、猫、鹿、狗、青蛙、马、船和卡车
代码实现
- 引入包&下载数据
import collections
import math
import os
# shutil 模块提供了一系列对文件和文件集合的高阶操作。
import shutil
import pandas as pd
import torch
import torchvision
from torch import nn
from d2l import torch as d2l

d2l.DATA_HUB['cifar10_tiny'] = (d2l.DATA_URL + 'kaggle_cifar10_tiny.zip','2068874e4b9a9f0fb07ebe0ad2b29754449ccacd')
#此数据集是保存在AWS的demo而非完整的cifar-10

demo = True

if demo:
    data_dir = d2l.download_extract('cifar10_tiny')
else:
    data_dir = '../code/data/cifar-10/'
数据集结构:
- ../data/cifar-10/train/[1-50000].png
- ../data/cifar-10/test/[1-300000].png
- ../data/cifar-10/trainLabels.csv
- ../data/cifar-10/sampleSubmission.csv
train 和 test 文件夹分别包含训练和测试图像,trainLabels.csv 含有训练图像的标签, sample_submission.csv 是提交文件的范例。
- 整理数据集
def read_csv_labels(fname):
    #labels存在csv文件里
    with open(fname, 'r') as f:
        lines = f.readlines()[1:]
        #readlines() 按行读取整个文件,。
    tokens = [l.rstrip().split(',') for l in lines]
    #strip()删除字符串头尾特定的字符,默认是空格和换行符
    #rstrip()在此删去右侧换行符
    #split()中间按照逗号分隔
    return dict(((name, label) for name, label in tokens))
    #把[]换成()的列表生成式,就是一个generator
    #可以用list/tuple(generator)方式转换
    #如果是成对元素,就可以dict(generator)转换成字典,相当于dict(list)的方式定义字典
    #以上的方式都会遍历generator
    #当同一个generator被遍历过一遍时,再次调用会返回None
    #比如生成器g,先list(g),会得到所有元素
    #再tuple(g),得到空元组,所以需要重新定义g

labels = read_csv_labels(os.path.join(data_dir, 'trainLabels.csv'))
- 将验证集从原始训练集中拆分
def copyfile(filename, target_dir):
    # 新建文件夹
    # exist_ok(default)=False,如果目标文件夹已存在会报错
    #对于已存在的文件夹不会覆盖
    os.makedirs(target_dir, exist_ok=True)
    #copy文件到目录
    shutil.copy(filename, target_dir)

def reorg_train_valid(data_dir, labels, valid_ratio):
    # 整体是把文件全部复制到train_valid并且分为train和valid,每个下面再以类名建立文件夹细分
    # collections.Counter是计数器
    # 元素以字典形式保存
    # most_common(num)返回最频繁的类型和频率,如果不指定个数,default所有类
    # 训练数据集中样本最少的类别中的样本数
    n = collections.Counter(labels.values()).most_common()[-1][1]
    # math.floor向下取整
    # valid_ratio决定了一个上限
    # 验证集中每个类别的样本数
    n_valid_per_label = max(1, math.floor(n * valid_ratio))
    print(n_valid_per_label)
    label_count = {}
    for train_file in os.listdir(os.path.join(data_dir, 'train')):
        #分离文件(图片)名与后缀,只提取文件名,也就是图片的序号
        #再在lables这个字典里拿出对应标号的类型名
        label = labels[train_file.split('.')[0]]
        # 文件名
        fname = os.path.join(data_dir, 'train', train_file)
        # 复制到训练文件夹
        copyfile(fname,os.path.join(data_dir, 'train_valid_test', 'train_valid', label))
        # 如果label不在label_count里或该label数量未达到每类验证集要求
        if label not in label_count or label_count[label] < n_valid_per_label:
            # 复制到验证集文件夹
            copyfile(fname, os.path.join(data_dir, 'train_valid_test', 'valid', label))
            #用字典计数
            #dict.get(key, default=None),查找类型,如果没有则返回默认值
            #借此赋值dict[key]
            #通过+1计数,并重新赋值
            label_count[label] = label_count.get(label, 0) + 1
        # 如果label包含在label_count
        else:
            # 复制到训练集文件夹
            copyfile(fname, os.path.join(data_dir, 'train_valid_test', 'train', label))
    return n_valid_per_label
- 在预测期间整理测试集,方便读取
# 创建测试集,并且只有一个unknown文件夹,表示所有类型均为不可知
def reorg_test(data_dir):
    for test_file in os.listdir(os.path.join(data_dir, 'test')):
        copyfile(
            os.path.join(data_dir, 'test', test_file),
            os.path.join(data_dir, 'train_valid_test','test','unkonwn'))
- 调用前面定义的函数
def reorg_cifar10_data(data_dir, valid_ratio):
    labels = read_csv_labels(os.path.join(data_dir, 'trainLabels.csv'))
    reorg_train_valid(data_dir, labels, valid_ratio)
    reorg_test(data_dir)

batch_size = 32 if demo else 128
valid_ratio = 0.1
reorg_cifar10_data(data_dir, valid_ratio)
- 图像增广
# 对训练集做增广:resize -> 随机大小缩放和裁剪 -> 水平翻转 -> 张量化 -> 归一化
transform_train = torchvision.transforms.Compose([
    torchvision.transforms.Resize(40),
    torchvision.transforms.RandomResizedCrop(32, scale=(0.64, 1.0),
                                                ratio=(1.0, 1.)),
    torchvision.transforms.RandomHorizontalFlip(),
    torchvision.transforms.ToTensor(),
    torchvision.transforms.Normalize([0.4914, 0.4822, 0.4465],
                                     [0.2023, 0.1994, 0.2010])])

# 对测试集做增广:张量化 -> 归一化
transform_test = torchvision.transforms.Compose([
    torchvision.transforms.ToTensor(),
    torchvision.transforms.Normalize([0.4914, 0.4822, 0.4465],
                                     [0.2023, 0.1994, 0.2010])])
- 读取由原始图像组成的数据集
# ImageFolder是一个通用的数据集加载器,也就是对自定义的图片文件夹
# 把data_dir/rain_valid_test/train作为训练集
# 把data_dir/rain_valid_test/train_valid作为训练验证集
train_ds, train_valid_ds = [
    torchvision.datasets.ImageFolder(
        os.path.join(data_dir, 'train_valid_test', folder),
        transform=transform_train) for folder in ['train', 'train_valid']]

# 把data_dir/rain_valid_test/valid作为验证集
# 把data_dir/rain_valid_test/test/unknown作为测试集
valid_ds, test_ds = [
    torchvision.datasets.ImageFolder(
        os.path.join(data_dir, 'train_valid_test', folder),
        transform=transform_test) for folder in ['valid', 'test']]
- 定义数据集迭代器
# :drop_last=True表示裁去最后不满batch_size的一批数据,default=False
# 为实现随机SGD,必须shuffle=True,否则数据集顺序也会被误学
train_iter, train_valid_iter = [
    torch.utils.data.DataLoader(
        dataset, batch_size, shuffle=True, drop_last=True)
    for dataset in (train_ds, train_valid_ds)]

valid_iter = torch.utils.data.DataLoader(
    valid_ds, batch_size, shuffle=False, drop_last=True)

test_iter =  torch.utils.data.DataLoader(test_ds, batch_size, shuffle=True,
                                         drop_last=False)
- 定义模型&损失函数
def get_net():
    num_classes = 10
    # :num_classes 类别数,3为RGB通道数
    net = d2l.resnet18(num_classes, 3)
    return net

loss = nn.CrossEntropyLoss(reduction='none')
- 定义训练过程
def train(net, train_iter, valid_iter, num_epochs, lr, wd, devices,
          lr_period, lr_decay):
    # momentum使用指数加权平均之后的梯度代替原梯度进行参数更新。
    # 因为每个指数加权平均后的梯度含有之前梯度的信息,动量梯度下降法因此得名。
    trainer = torch.optim.SGD(net.parameters(), lr=lr, momentum=0.9,
                              weight_decay=wd)
    # 使用调度器来启用自适应学习率
    # 每隔lr_period个epoch, 学习率下降lr * lr_decay
    scheduler = torch.optim.lr_scheduler.StepLR(trainer, lr_period, lr_decay)
    # 作图相关
    num_batches, timer = len(train_iter), d2l.Timer()
    legend = ['train loss', 'train acc']
    if valid_iter is not None:
        legend.append('valid acc')
    animator = d2l.Animator(xlabel='epoch', xlim=[1, num_epochs],
                            legend=legend)
    # 数据并行
    net = nn.DataParallel(net, device_ids=devices).to(devices[0])
    for epoch in range(num_epochs):
        net.train()
        metric = d2l.Accumulator(3) # loss, accuracy, numel
        for i, (features, labels) in enumerate(train_iter):
            timer.start()
            l, acc = d2l.train_batch_ch13(net, features, labels, loss, trainer, devices)
            metric.add(l, acc, labels.shape[0])
            timer.stop()
            if (i + 1) % (num_batches // 5) == 0 or i == num_batches - 1:
                animator.add(epoch + (i + 1) / num_batches, (metric[0] / metric[2], metric[1] / metric[2], None))
        if valid_iter is not None:
            valid_acc = d2l.evaluate_accuracy_gpu(net, valid_iter)
            animator.add(epoch + 1, (None, None, valid_acc))
        # 使用自适应学习率后,原先的`optimizer.step()`写法
        # 需替换为`scheduler.step()`
        scheduler.step()

    measures = (f'train loss {metric[0] / metric[2]:.3f}, '
                f'train acc {metric[1] / metric[2]:.3f}')
    if valid_iter is not None:
        measures += f', valid acc {valid_acc:.3f}'
    print(measures + f'\n{metric[2] * num_epochs / timer.sum():.1f}'
          f' examples/sec on {str(devices)}')
- 训练和验证模型
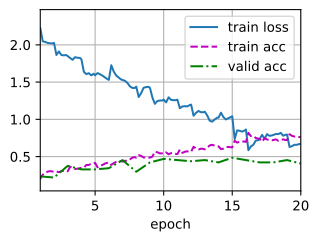
devices, num_epochs, lr, wd = d2l.try_all_gpus(), 20, 2e-4, 5e-4
lr_period, lr_decay, net = 4, 0.9, get_net()
train(net, train_iter, valid_iter, num_epochs, lr, wd, devices, lr_period,
      lr_decay)
# Out:
# train loss 0.685, train acc 0.751, valid acc 0.359
# 804.0 examples/sec on [device(type='cuda', index=0), device(type='cuda', index=1)]
- 在 Kaggle 上对测试集进行分类并提交结果
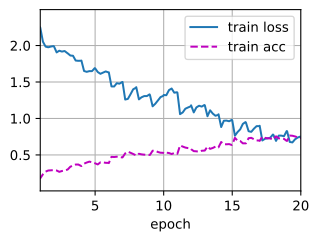
net, preds = get_net(), []
train(net, train_valid_iter, None, num_epochs, lr, wd, devices, lr_period,
      lr_decay)

for X, _ in test_iter:
    y_hat = net(X.to(devices[0]))
    preds.extend(y_hat.argmax(dim=1).type(torch.int32).cpu().numpy())
sorted_ids = list(range(1, len(test_ds) + 1))
sorted_ids.sort(key=lambda x: str(x))
df = pd.DataFrame({'id': sorted_ids, 'label': preds})
df['label'] = df['label'].apply(lambda x: train_valid_ds.classes[x])
df.to_csv('submission.csv', index=False)
# Out:
# train loss 0.684, train acc 0.759
# 1052.1 examples/sec on [device(type='cuda', index=0), device(type='cuda', index=1)]
Python 模块参考文档
shutilPython 高阶文件操作包 🧐官方中文torchvision.datasets.ImageFoldertorchvison 从文件夹内构造数据集方法 🧐中文官方英文 torch.optim.lr_schedulerPytorch 自适应学习率相关文档 🧐官方英文
Q&A🤓
Q:深度学习的损失函数一般是非凸的吗?
🙋♂️:一般损失函数的数学形式(如交叉熵损失函数、线性回归的最小二乘法等)是凸函数,但有隐藏层和激活函数的神经网络的数学形式都是非凸的,带来其损失函数的求解就是非凸优化问题。但只追求凸函数是没有意义的,凸函数的表示能力有限,不能拟合复杂问题。
配图说明:部分旧版图片链接已失效,现采用教材对应章节中的 PyTorch 示例图;图中数值可能与笔记保留的历史运行输出略有不同。