
批量归一化
Published:
本文介绍批量归一化在深层网络中的作用,说明训练和预测阶段的计算差异,对比 BatchNorm、LayerNorm 等归一化方法,并给出实现与实验示例。
🎦 本节课程视频地址 👇
网络越深产生的问题
- 反向传播,损失的梯度从输出层向后传,靠近输出的层训练较快
- 梯度往下越传递越小(小数相乘)
- 数据在最底部
- 靠近数据的底部层训练较慢
- 底部层一变化,所有都得跟着变,相当于低层特征改变,不断抽象得到的高层特征也会随之改变
- 顶部的那些层需要重新学习多次
- 导致收敛变慢
对于典型的多层感知机或卷积神经网络。当我们训练时,中间层中的变量(例如,多层感知机中的仿射变换输出)可能具有更广的变化范围:不论是沿着从输入到输出的层,跨同一层中的单元,或是随着时间的推移,模型参数的随着训练更新变幻莫测。 批量归一化的发明者非正式地假设,这些变量分布中的这种偏移可能会阻碍网络的收敛。 直观地说,我们可能会猜想,如果一个层的可变值是另一层的 100 倍,这可能需要对学习率进行补偿调整。
同时,更深层的网络很复杂,容易过拟合。 这意味着正则化变得更加重要。
如何解决
批量归一化(batch normalization)
批量归一化(batch normalization) [Ioffe & Szegedy, 2015],是一种流行且有效的技术,可持续加速深层网络的收敛速度。 再结合后期介绍的残差块,批量归一化使得研究人员能够训练100层以上的网络。
批量规范化应用于单个可选层(也可以应用到所有层),其原理如下:在每次训练迭代中,我们首先规范化输入,即通过减去其均值并除以其标准差,其中两者均基于当前小批量处理。
批量归一化固定每一个小批量(在不同层输出)里面的均值和方差:
\[\mu_B={1 \over \vert B\vert } \sum_{i \in B} x_i \\ \sigma_B^2={1 \over \vert B\vert } \sum_{i \in B} (x_i-\mu_B)^2 + \epsilon\]其中\(B\)指一个批量 Batch,\(\epsilon\)为一个很小的数,防止方差为零,在下文无法进行除零运算
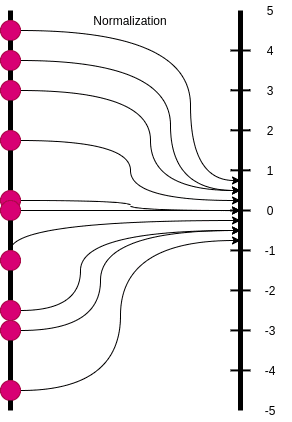
然后再通过下式对每个批量在不同层的输出值数据做额外的调整,应用比例系数\(\gamma\)和比例偏移\(\beta\),将每层输出值固定为均值为\({\beta}\)、方差为\({\gamma}\)的分布:
\[x_{i+1}=\gamma{x_i-\mu_B \over \sigma_B} + \beta\]批量归一化层
- 比例系数\({\gamma}\)和偏移系数\({\beta}\)是学习出来的
- 批量归一化是一个线性变换
- 作用位置
- 全连接层和卷积层输出上,激活函数之前
因为一般激活函数(如 relu) 会将数据映射为正数,所以不能再带回正负各异的状态
- 全连接层和卷积层输入上
- 全连接层和卷积层输出上,激活函数之前
- 对于全连接层,作用在特征维(独立改变每个特征的分布)
- 对于卷积层,作用于通道维(即一个滑动窗口里像素的特征)
批量归一化的作用
- 可以加速收敛并让训练更稳定(因为可以用更大的学习率,而防止学习率过大造成的无法收敛抖动或者靠近输出层梯度爆炸的问题)
- 一般不改变模型的精度
- 只有批量足够大和运用在深层网络时,批量归一化效果才能有效且稳定。如果我们尝试使用大小为1的小批量应用批量规范化,将无法学到任何东西。
因为在减去均值之后,每个隐藏单元将为0。 所以,只有使用足够大的小批量,批量规范化这种方法才是有效且稳定的。 请注意,在应用批量规范化时,批量大小的选择可能比没有批量规范化时更重要
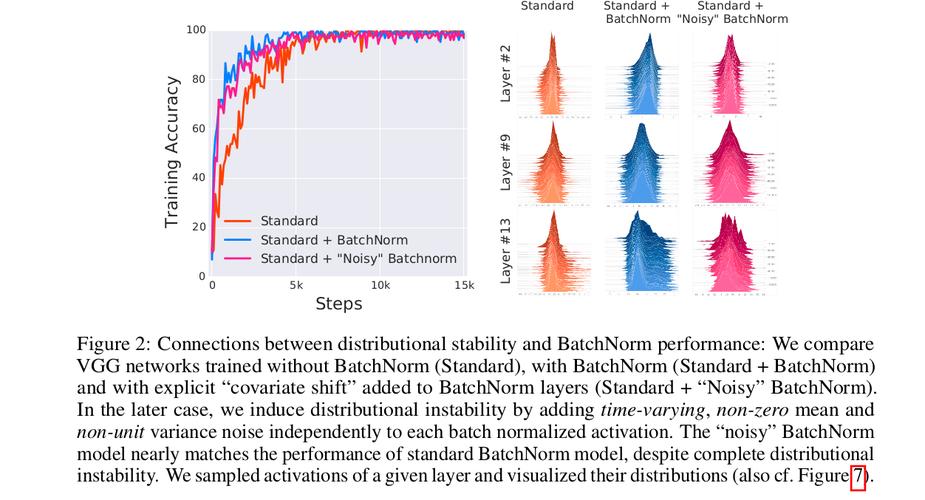
上图以使用 VGG 网络为例展示 BatchNorm 的效果,橙色代表标准结构,蓝色代表增加了 BatchNorm 的对比结构,品红色代表增加了“Noisy BatchNorm”的对比结构。从左侧图可看出加入 BatchNorm 后,训练精读收敛得更快,同时抖动更小(但不改变最终的精度);从右侧图可看出加入 BatchNorm 后,各层输出分布更加“均衡”。
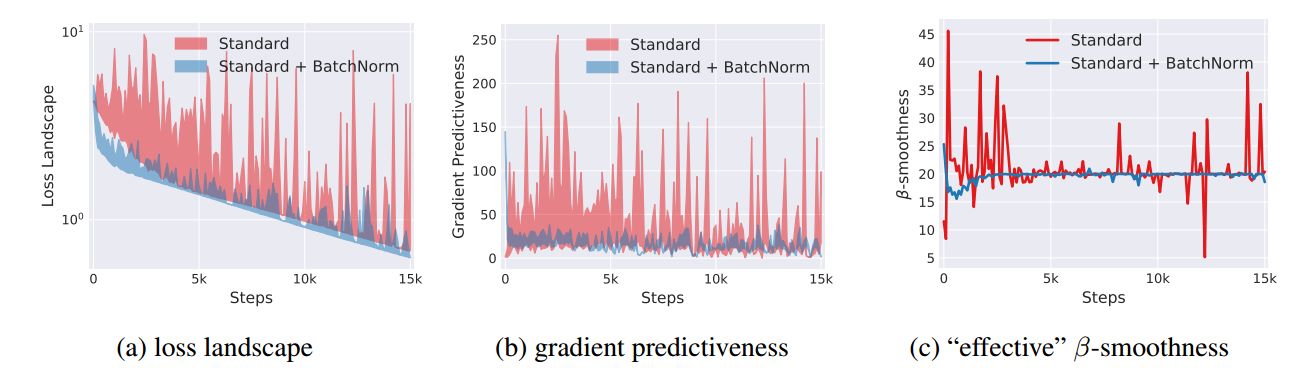
通过上图对比实验,可以看出使用 BN 后,损失下降更快更平稳,梯度抖动更稳定。
批量归一化作用的原理
- 最初的论文表示可以减少内部协变量转移
- 后续论文指出 batch normalization 相当于在小批量里增加噪音\(\mu,\sigma\),对数据进行了随机偏移和缩放(目前还没有一个统一的结论)
- 没必要和丢弃法混合使用(在番外 04-Kaggle 竞赛实践经验一篇中有相关实践证明)
BatchNorm、LayerNorm、InstanceNorm、GroupNorm 区别
目前常用的有BatchNorm、LayerNorm、InstanceNorm、GroupNorm四种归一化方法。
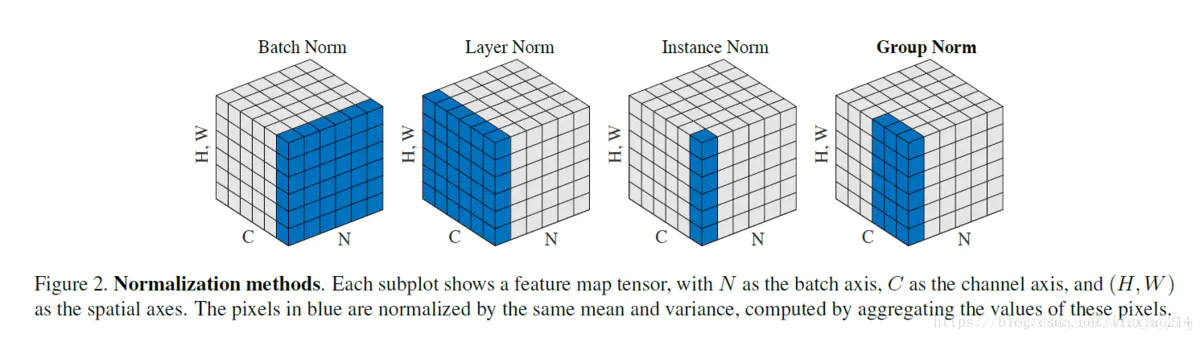
上图中每个立方体代表一个 Batch 的数据,其中 C 代表 Channel 通道维,N 代表 batch 维,(H,W)代表一个空间维(例如二维图像)
- BatchNorm: 是在 batch 上作用于每个 Channal 维的归一化,多用于 CNN,对小 batchsize 效果不好
- LayerNorm: 在通道方向上作用于一个 batch 中一个样本(如一张图的所有通道)的归一化,主要对 RNN 作用明显,现多用于 Transformer,可参考笔记 👉56-Transformer
- InstanceNorm: 作用于一个样本的一个通道的归一化,多用在风格化迁移
- GroupNorm: 将 channel 分组,然后再做归一化, 在 batchsize<16 的时候, 可以使用这种归一化
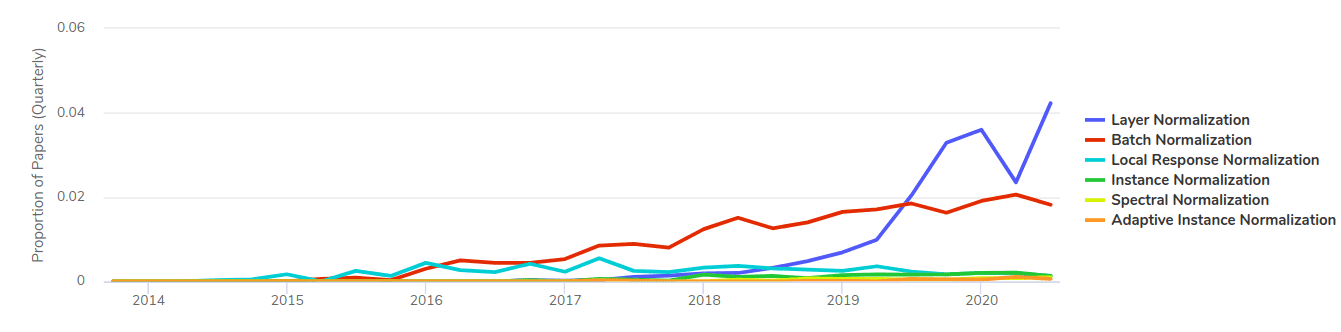
上图展示了各种 Normalization 的论文使用率,可看出随着 Transformer 及其变种的广泛应用,LayerNorm 使用率逐年增高;主流方法还是 BatchNorm 与 LayerNorm
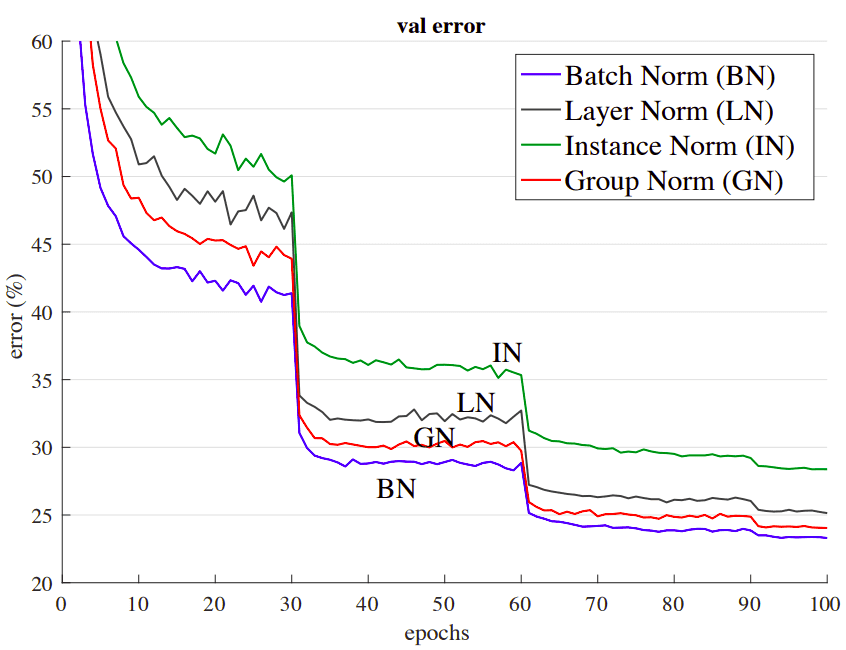
上图展示了在相同 ResNet-50 网络架构下,不同归一化方法的验证误差比较图(batch size=64 images)
具体关于四种归一化的综述,可以参考 AISummer 这篇文章 👉[1]和这篇知乎
代码实现
- 定义 batch_norm 运算
import torch
from torch import nn
from d2l import torch as d2l

def batch_norm(X, gamma, beta, moving_mean, moving_var, eps, momentum):
    # moving_mean/var全局的期望和方差,近似于整个数据集上
    # eps:很小的固定值,避免除零,很重要
    # momentum:用于更新moving的动量,通常取固定值
    if not torch.is_grad_enabled(): #做inference而非train,所以不求梯度
        # 使用整个数据集的均值和方差计算
        X_hat = (X - moving_mean) / torch.sqrt(moving_var + eps)
    else:
        assert len(X.shape) in (2, 4)
        # X.shape输入要么为2,代表全连接层(batch_samples,features)
        if len(X.shape) == 2:
            #按特征求均值和方差
            mean = X.mean(dim=0)    # 按行求均值,将每列求均值后压缩到一行
            var = ((X - mean)**2).mean(dim=0)
        # 要么为4,代表2D卷积层,(batch_samples,channals,w,h)
        else:
            # 对每一个通道的全部元素求均值方差,得到一个(1,channal_num,1,1)的矩阵
            # dim指代的维数表明计算后该维度压缩为1
            mean = X.mean(dim=(0, 2, 3), keepdim=True)
            var = ((X - mean)**2).mean(dim=(0, 2, 3), keepdim=True)

        # 对X每个元素进行归一化
        X_hat = (X - mean) / torch.sqrt(var + eps)
        # 对moving_mean、moving_var做滑动窗口平滑更新,类似动量
        moving_mean = momentum * moving_mean + (1.0 - momentum) * mean
        moving_var = momentum * moving_var + (1.0 - momentum) * var
    Y = gamma * X_hat + beta
    return Y, moving_mean.data, moving_var.data
- 定义 BatchNorm 层
因为依据上文所述,gamma、beta是需要更新的参数,所以需要使用nn.Parameter来构造保证可存储梯度从而可被优化器进行更新
class BatchNorm(nn.Module):
    def __init__(self, num_features, num_dims):
        super().__init__()
        if num_dims == 2:   # 全连接层
            shape = (1, num_features)
        else:   # 2D卷积层
            shape = (1, num_features, 1, 1)
        # gamma和beta是需要参数学习的参数,使用Parameter存储梯度
        self.gamma = nn.Parameter(torch.ones(shape))
        self.beta = nn.Parameter(torch.zeros(shape))
        # 需要不断迭代拟合的全局均值方差
        # 初始化时由于无法得到全局值,首先给定一个初始值
        self.moving_mean = torch.zeros(shape)
        self.moving_var = torch.ones(shape)

    def forward(self, X):
        # 检测moving_mean/var所在设备,如果与数据不在一起,则移动到数据所在设备
        if self.moving_mean.device != X.device:
            self.moving_mean = self.moving_mean.to(X.device)
            self.moving_var = self.moving_var.to(X.device)

        Y, self.moving_mean, self.moving_var = batch_norm(
            X, self.gamma, self.beta, self.moving_mean,
            self.moving_var, eps=1e-5, momentum=0.9)
        return Y
- 将 BatchNorm 嵌套进一个 LeNet 神经网络
net = nn.Sequential(
    nn.Conv2d(1, 6, kernel_size=5), BatchNorm(6, num_dims=4),
    nn.Sigmoid(), nn.MaxPool2d(kernel_size=2, stride=2),
    nn.Conv2d(6, 16, kernel_size=5), BatchNorm(16, num_dims=4),
    nn.Sigmoid(), nn.MaxPool2d(kernel_size=2, stride=2),
    nn.Flatten(), nn.Linear(16 * 4 * 4, 120),
    BatchNorm(120, num_dims=2), nn.Sigmoid(),
    nn.Linear(120, 84), BatchNorm(84, num_dims=2),
    nn.Sigmoid(), nn.Linear(84, 10))
#对线性层只有(256,16*4*4)矩阵的norm
- 训练
lr, num_epochs, batch_size = 1.0, 10, 256
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)
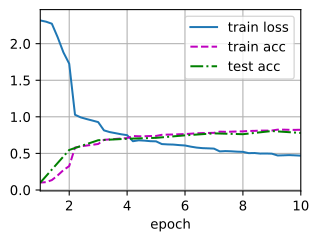
d2l.train_ch6(net, train_iter, test_iter, num_epochs, lr, d2l.try_gpu())

# Out:
# loss 0.271, train acc 0.899, test acc 0.862
# 32546.7 examples/sec on cuda:0
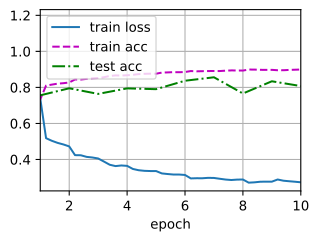
对比原始LeNet结果:可知收敛更快,推理速度减慢20%
# Out:(Original LeNet)
# loss 0.473, train acc 0.823, test acc 0.786
# 40832.5 examples/sec on gpu(0)
# 查看net索引为1的batchnorm层参数
net[1].gamma.reshape((-1,)), net[1].beta.reshape((-1,)) #-1表示自动计算行,所以默认填充所有列

# Out:
# (tensor([2.6914, 2.5985, 3.8031, 2.4383, 1.4624, 2.6880], device='cuda:0',
#         grad_fn=<ViewBackward>),
#  tensor([-3.1298,  2.5322, -2.1505,  2.3287,  0.0692,  1.7874], device='cuda:0',
#         grad_fn=<ViewBackward>))
- 简明实现
#注意1d与2d的区别。
net = nn.Sequential(
    nn.Conv2d(1, 6, kernel_size=5), nn.BatchNorm2d(6),
    nn.Sigmoid(), nn.MaxPool2d(kernel_size=2, stride=2),
    nn.Conv2d(6, 16, kernel_size=5), nn.BatchNorm2d(16),
    nn.Sigmoid(), nn.MaxPool2d(kernel_size=2, stride=2),
    nn.Flatten(), nn.Linear(16 * 4 * 4, 120),
    nn.BatchNorm1d(120), nn.Sigmoid(),
    nn.Linear(120, 84), nn.BatchNorm1d(84),
    nn.Sigmoid(), nn.Linear(84, 10))

# nn.Flatten()
#默认从第1个维度(而不是第0维)开始拉平直至最后一个维度
#所以Flatten()一个二维矩阵不发生任何形状变化。
卡尔曼滤波
在此笔记初版时,理解代码实现时,我们以为在更新
moving_mean和moving_var时采用了卡尔曼滤波的思想,所以写了本段内容,后来校订时发现其实使用的是动量的思想。Anyway,就把之前创作的内容贴在最后,也是一种学习嘛,不亏😛
在推理的时候,样本一个一个进入网络,没有批量均值、方差可求。可以用训练数据集得到均值、方差作为初值,不断迭代逼近全局的均值方差。全局期望的更新要借助Karlman 滤波[2]
点击下图参考 Matlab 官方制作的优秀科普视频 👇
对同一个目标,多次测量值\(z_1,z_2,z_3,...,z_k\),其期望\(x_1, x_2,...,x_k\)
\[\begin{aligned} \hat x_k&={1\over k}(z_1+z_2+z_3+...+z_{k-1}+z_k)\\ &={1\over k}(z_1+z_2+z_3+...+z_{k-1})+{1\over k}z_k\\ &={1\over k}{k-1\over k-1}(z_1+z_2+z_3+...+z_{k-1})+{1\over k}z_k\\ &={k-1\over k}\hat x_{k-1}+{1\over k}z_k\\ &=\hat x_{k-1}-{1\over k}\hat x_{k-1}+{1\over k}z_k\\ &=\hat x_{k-1}+{1\over k}(z_k-\hat x_{k-1}) \end{aligned}\]随着\(k\)的增加,测量值\(z_k\)就不再重要
\[\hat x_k=\hat x_{k-1}+k_k(z_k-\hat x_{k-1})\]\(k_k\): Karlman Gain
当前估计值=上一次的估计值+系数 ×(当前测量值-上一次的估计值)
- 只与上一次的估计值有关,递归算法。
估计误差:\(e_e\),测量误差:\(e_m\)
- \(e_e\gt\gt e_m: k_k\rightarrow1\quad \hat x_k=\hat x_{k-1}+z_k-\hat x_{k-1}=z_k\),当估计误差远大于测量误差时,以测量值为准
- \(e_e\lt\lt e_m: k_k\rightarrow0\quad \hat x_k=\hat x_{k-1}\)当估计误差远小于测量误差时,以估计值为准
Pytorch 模块参考文档
参考资料
[1] in-layer normalization techniques for training very deep neural networks
[2] 卡尔曼滤波-维基百科
Q&A🤓
Q:本篇介绍的BachNorm和之前提到的Xavier随机初始化方法在效果上有什么关系?
🙋♂️:本质上BachNorm和Xavier初始化思路是相似的,都是要使模型在训练过程中更加稳定。Xavier初始化是在训练初,使得梯度处于比较稳定的范围,但不能保证之后的状态;BatchNorm是在每次批量训练时,强行通过归一化使对应层梯度处于比较稳定的状态而不至于梯度消失或爆炸。
配图说明:部分旧版图片链接已失效,现采用教材对应章节、教材对应章节中的 PyTorch 示例图;图中数值可能与笔记保留的历史运行输出略有不同。