
丢弃法(Dropout)
Published:
本文介绍丢弃法的基本思想,说明如何通过无偏噪声缓解过拟合,区分训练与预测阶段的处理方式,并给出 Dropout 的从零实现与 PyTorch 简洁实现。
🎦 本节课程视频地址 👇
动机
- 一个好的模型需要对输入数据的扰动鲁棒(Robust)
- 使用有噪音的数据等价于Tikhonov 正则(又称:岭回归)
- 丢弃法:相当于在层之间加入噪音。
无偏差的加入噪音
- 对\({\bf x}\)加入噪音得到\({\bf x\prime}\),我们希望不改变原有期望\(\bf E\)
- 丢弃法对每个元素进行如下扰动:
相当于有一定概率 \(p\) 使一个值变为零,否则使之变大。这种定义下,可保证期望\(E\)不变。
使用丢弃法训练过程
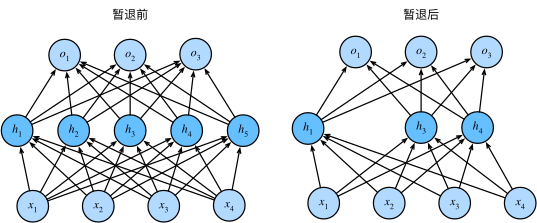
通常将丢弃法\(dropout()\)作用在多层感知机的隐藏层输出上:
\[{\bf h}=\sigma({\bf W_1x+b_1}) \\ {\bf h^\prime}=dropout({\bf h}) \\ {\bf o}={\bf W_2h^\prime+b_2} \\ {\bf y}=softmax({\bf o}) \\\]- 丢弃概率\(p\)是控制模型复杂度的超参数,\(p\)越大,模型复杂度越小,反之亦然
- 一般只用于全连接神经网络(多层感知机),而权重衰退(Weight Decay)通用性更强
- 一般可以将模型复杂度设置得大一些(比如隐藏层数量更多、隐藏层更大),再添加 Dropout 操作,效果可能会好于一个无 Dropout 的稍简单的网络
推理(预测)中的丢弃法
- 正则项只在训练中使用:他们影响模型参数的更新
- 在推理过程中,丢弃法直接返回输入
这样也能保证预测时模型结构的固定,有确定性的输出,否则模型结构将会发生随机改变,导致结果不可控。
当年 Hinton 老爷子认为,dropout 相当于每一次采样一个子神经网络做集成训练。在后来人们的研究中,Dropout 表现出的效果更像是一个正则项。
代码实现
- 定义 dropout 函数
import torch
from torch import nn
from d2l import torch as d2l

def dropout_layer(X, dropout):
    assert 0 <= dropout <= 1    # assert如果不满足条件,则报错

    if dropout == 1:    # 丢弃所有
        return torch.zeros_like(X)
    if dropout == 0:    # 保留所有
        return X

    # 生成掩码mask,先使用判断生成Bool类型,再转换成浮点类型
    # mask中小于指定概率将被置0,剩余为1
    mask = (torch.randn(X.shape)  > dropout).float()

    return mask * X / (1.0 -dropout)    # 工程小技巧,使用mask而不是随机选取再运算可以提高运算效率
- 定义模型
#x.shape=(1,784),y.shape=(1,10),w1.shape=(784,256),w2.shape=(256,256),w3.shape=(256,10)

num_inputs, num_outputs, num_hiddens1, num_hiddens2 = 784, 10, 256, 256
dropout1, dropout2 = 0.2, .5

class Net(nn.Module):
    def __init__(self, num_inputs, num_outputs, num_hiddens1, num_hiddens2, is_training=True):
        super(Net, self).__init__()     # super().__init__() 用于继承父类初始化方法

        self.num_inputs = num_inputs
        self.training = is_training

        # 定义各层神经元
        self.lin1 = nn.Linear(num_inputs, num_hiddens1) # (784,256) h1=xWT
        self.lin2 = nn.Linear(num_hiddens1, num_hiddens2)   # (256,256)
        self.lin3 = nn.Linear(num_hiddens2, num_outputs)    # (256,10)
        self.relu = nn.ReLU()

    def forward(self, X):
        H1 = self.relu(self.lin1(X.reshape((-1, self.num_inputs)))) # (1,784)*(784,256)=(1*256)

        if self.training == True:
            H1 = dropout_layer(H1, dropout1)
        H2 = self.relu(self.lin2(H1))   #(1,256)*(256,256)=(1,256)

        if self.training == True:
            H2 = dropout_layer(H2, dropout2)
        out = self.lin3(H2) #(256,256)*(256,10)=(1,10)
        return out

net = Net(num_inputs, num_outputs, num_hiddens1, num_hiddens2)
- 训练
num_epochs, lr, batch_size = 10, .5, 256
loss = nn.CrossEntropyLoss()    #打包了softmax

train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)
trainer = torch.optim.SGD(net.parameters(), lr=lr)  #net.parameters(recurse=True)返回模块和所有子模块的参数。

d2l.train_ch3(net, train_iter, test_iter, loss, num_epochs, trainer)
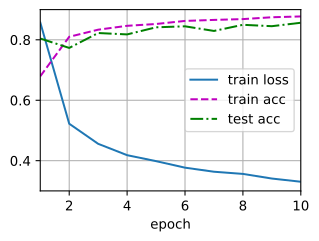
- 接着进行对比试验,看如果其他条件不变,不使用 Dropout 结果有什么区别,这里再定义一个 Net2 类,继承自 Net,去掉 Dropout 操作,其他不变:
class Net2(Net):
    def __init__(self, num_inputs, num_outputs, num_hiddens1, num_hiddens2,
                 is_training = True):
        super().__init__(num_inputs, num_outputs, num_hiddens1, num_hiddens2,
                 is_training = True)
    def forward(self, X):
        H1 = self.relu(self.lin1(X.reshape((-1, self.num_inputs))))
        H2 = self.relu(self.lin2(H1))
        out = self.lin3(H2)
        return out

net2 = Net2(num_inputs, num_outputs, num_hiddens1, num_hiddens2)
- 训练对照组
trainer2 = torch.optim.SGD(net2.parameters(), lr=lr)
d2l.train_ch3(net2, train_iter, test_iter, loss, num_epochs, trainer2)
- 对照结果(左图:有 Dropout;右图:无 Dropout)
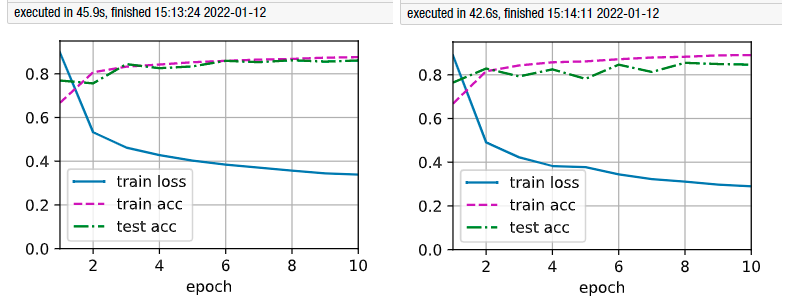
可看出有 Dropout,训练误差稍高于无 Dropout,但测试精度也稍高于无 Dropout 网络,泛化能力增强。
- 简洁实现
net = nn.Sequential(nn.Flatten(),
                  nn.Linear(784, 256),
                  nn.ReLU(),
                  nn.Dropout(dropout1),
                  nn.Linear(256, 256),
                  nn.ReLU(),
                  nn.Dropout(dropout2),
                  nn.Linear(256, 10))
def init_weights(m):
    if type(m) == nn.Linear:
        nn.init.normal_(m.weight, std=0.01)

net.apply(init_weights)

trainer = torch.optim.SGD(net.parameters(), lr=lr)
d2l.train_ch3(net, train_iter, test_iter, loss, num_epochs, trainer)
nn.Dropout模块在评估(推理)时,会自动停止 Dropout 操作
Pytorch 模块参考文档
Q&A🤓
Q:Dropout 在训练的时候进行随机丢弃,在推理的时候又都不丢弃,这样在预测时候,不就相当于还在一个“可能”过拟合的网络结构上使用(所有神经元都为可用)?
🙋♂️:关于这点,可以点击以下视频 👇 观看吴恩达 DeepLearning.ai 中一节课程《Why does Dropout work?》
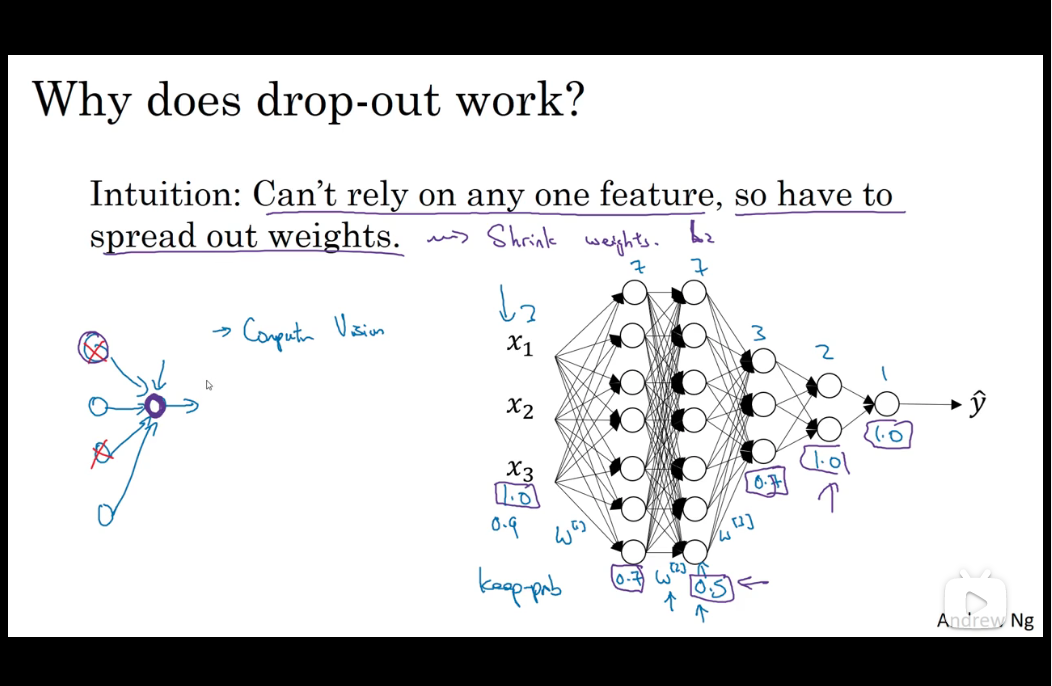
大致观点是,Dropout 在训练过程中,通过随机置零神经元结构,使得 Dropout 下层神经元不能过分依赖上层的某些输入,而不得不 Spread out 权重,这会导致权重收缩(Shrink Weights),从而达到和 L2 正则一样的效果。
结合吴恩达的观点,私以为神经网络在预测时虽然网络结构依旧完整(相比训练时,反而可用的神经元更多),但经过 Dropout 训练时的“调教”,使得神经元权重分配更加“合理”,不会过分地关注某些特征而造成过拟合,同时在数学上相当于增加了正则项,所以限制了模型复杂度。
Q:Dropout和前一节的权重衰退等正则化方法相比具体有什么关系?有没有一个综述性的对比讲解?
🙋♂️:Of Course!在我们笔记主页推荐过的博客TheAISummer上有一篇综述性文章可供参考👉Regularization techniques for training deep neural networks
配图说明:部分旧版图片链接已失效,现采用教材对应章节中的 PyTorch 示例图;图中数值可能与笔记保留的历史运行输出略有不同。